GEO構造化データとは?AIに引用されるスキーマ実装ガイド
GEO構造化データとは、ChatGPT・Gemini・PerplexityなどのAI検索システムに「コンテンツの意味・文脈・信頼性」を正確に伝えるためのスキーマ設計手法です。
従来のSEO向け構造化データがGoogleのリッチリザルト表示を主目的としていたのに対し、GEO構造化データはLLM(大規模言語モデル)がサイトをエンティティとして理解し、回答生成の参照元として採用することを目的とします。
GEO(生成エンジン最適化)の全体像や戦略の考え方はGEOとは?AI時代の生成エンジン最適化にまとめています。本記事はそのうち構造化データの実装に絞り、JSON-LDの具体的な書き方からエンティティ設計、主要スキーマの実装ポイントまでを解説します。
当社ではSEOラボの運営を通じて、構造化データの実装状況とAI検索からの引用・流入の関係を継続的に観察しています。本記事は、その知見をふまえた実務レベルのガイドです。
この記事でわかること
- GEO構造化データとSEO構造化データの違い
- AIに認識されるエンティティ設計
- 主要スキーマ(Organization/Article/FAQ)の実装
- JSON-LDの具体的な書き方
おすすめの読者層
- AI検索からの引用・流入を増やしたいWeb/SEO担当者の方
- 各AI検索の違いを整理してAI検索対策を始めたい方
- 専門・ニッチ領域で指名や引用の先行者利益を狙いたい方
1. GEO構造化データとは?SEO構造化データとの違い
まず、両者の目的の違いを整理します。
| 比較項目 | SEO構造化データ | GEO構造化データ |
|---|---|---|
| 主な受け手 | Googleクローラー | LLM(大規模言語モデル) |
| 目的 | リッチリザルト表示 | AI引用・エンティティ認識 |
| 重視する要素 | ページ要素の分類 | 意味的関係・文脈・信頼性 |
| 評価軸 | クリック率・SERP占有 | AI回答での引用率 |
| 主要スキーマ | Product・Recipe・Event | Organization・Article・FAQPage・Person |
| sameAsの重要度 | 低い(任意) | 高い(実質必須) |
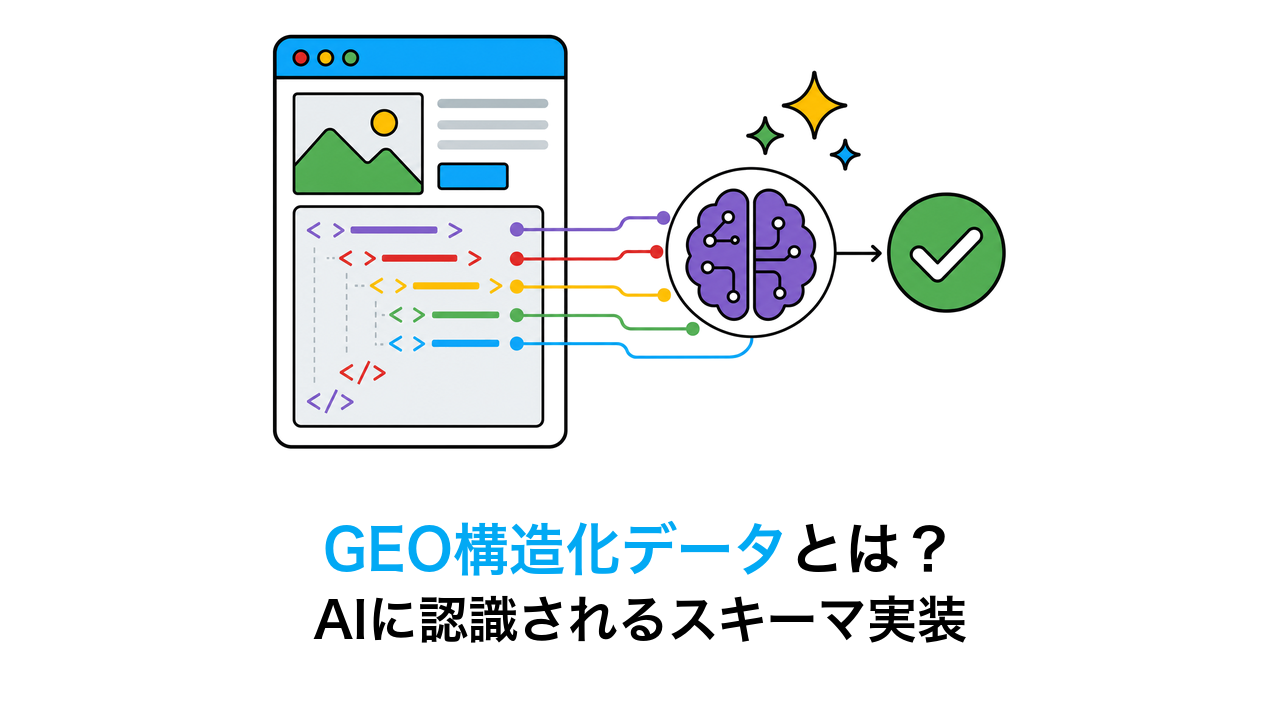
重要な認識の転換として、LLMはHTMLの見た目ではなくテキストの意味的文脈とメタデータを解析します。構造化データは、このセマンティクス理解を補強する「AIへの注釈」として機能します。例えばJSON-LDでOrganizationスキーマを設置すれば、LLMは「このドメインは〇〇という企業が運営する、△△分野の専門サイトである」と認識しやすくなります。
GEO構造化データの要点は次の3点に集約されます。
- エンティティとしての自己定義:Organization・Person・BrandスキーマでAIに「誰であるか」を宣言する
- 意味的関係の明示:sameAs・about・mentionsで他エンティティとの関係をリンクする
- 信頼性シグナルの構造化:author・publisher・datePublished・citationで一次情報性を示す
2. なぜAI検索時代に構造化データが重要なのか
2025年後半以降、Google検索でのAI Overviews表示が拡大しており、検索結果をクリックせず回答だけを得るユーザーが増えているとされています。AI Overviews対策と合わせて、この変化のもとでは「引用元として選ばれるか」がサイトの価値を左右します。
LLMが引用元を選ぶ際に参照するとされるシグナルには、次のようなものがあります。
- コンテンツの一次情報性(独自調査・専門家監修)
- サイトのエンティティ認識度(ナレッジグラフへの登録状況)
- 構造化データによる意味的明示(誰が・何を・いつ書いたか)
- 外部の権威あるサイトからの言及・引用
このうち構造化データは、サイト側が直接コントロールできる数少ないシグナルです。適切に実装することで、一次情報性や権威性といった他のシグナルの伝わり方も改善します。なので、AIに引用される対策に取り組む際は、コンテンツの中身と並行して構造化データの整備を進めるのが効率的です。
3. 実装の基本原則5つ
原則1:エンティティファースト設計
ページ単位ではなく「サイト全体が何者か」を定義するOrganizationスキーマを、サイト全ページのheadに設置します。これがGEO構造化データの基盤です。
原則2:sameAsで外部エンティティと接続する
WikidataのQID・Wikipedia URL・公式SNSアカウントURLをsameAsプロパティに列挙し、LLMが既知の知識ベースとサイトを接続できるようにします。
原則3:コンテンツの一次情報性を構造化する
Articleスキーマのauthor・citationプロパティで「誰が・どんな根拠で書いたか」をデータとして明示します。E-E-A-Tのうち特に「経験(Experience)」は、自社が実際に観測したデータや検証結果でしか示せません。一次情報をコンテンツに盛り込んだうえで、それを構造化データで裏づける流れが理想です。
原則4:FAQをAI回答形式に最適化する
FAQPageスキーマのanswerは、質問に対して完結した文章で答える設計にします。LLMは質問と回答のペアをそのまま回答生成に利用する傾向があるため、曖昧な回答は引用されにくくなります。
原則5:更新シグナルを明示する
datePublished・dateModifiedを正確に設置し、情報の鮮度をLLMに伝えます。AI検索は新しい情報を優先的に引用する傾向があるため、内容を更新したら日付も必ず更新します。
4. エンティティ設計とナレッジグラフ接続
SEOにおけるエンティティとは、ナレッジグラフ上で「固有の存在として識別できるもの」を指します。人物・企業・場所・概念などがエンティティとして登録されており、LLMはこうしたナレッジグラフのデータを学習データの一部として取り込んでいるとされます。
つまり、ブランドやサイトがエンティティとして認識されているほど、LLMが回答生成時に参照する可能性が高まると考えられます。GEO構造化データにおけるエンティティ設計とは、この認識を構造化データによって補強するアプローチです。
LLMがサイトを認識するプロセスは、おおむね次のようなイメージです。
- クロール時にJSON-LDのOrganizationスキーマを読み込む
- sameAsのWikidata QIDから既知の知識ベースと照合する
- Articleスキーマのabout・mentionsから関連概念・トピックを把握する
- FAQPageの質問・回答ペアを回答生成の材料として記録する
- 外部サイトのcitationやリンクと組み合わせてエンティティの信頼度を評価する
ナレッジグラフへの登録は、GEO文脈で有力な権威シグナルの一つとされています。登録に向けては、次のような施策が有効です。
- Wikidataへのエントリ作成(企業・人物)
- Wikipedia記事の作成、または言及の獲得
- プレスリリース・業界メディアへの掲載
- OrganizationスキーマのsameAsにWikidata QIDを明記
5. 主要スキーマの書き方【JSON-LD例】
ここではOrganization・Article・FAQPage・BreadcrumbListの4つを取り上げます。いずれもAIに認識されやすい主要スキーマです。ドメインやIDは例として example.com を使用しているので、実装時は自社ドメインに置き換えてください。
Organizationスキーマ(サイト全ページに設置)
「サイトが何者か」を宣言する土台です。sameAsにWikidata QIDやWikipedia URL、公式SNSを列挙することが、GEO観点での重要度を大きく左右します。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 |
<script type="application/ld+json"> { "@context": "https://schema.org", "@type": "Organization", "@id": "https://example.com/#organization", "name": "株式会社サンプル", "url": "https://example.com", "logo": { "@type": "ImageObject", "url": "https://example.com/logo.png" }, "description": "○○分野における専門メディアを運営する企業です。", "sameAs": [ "https://www.wikidata.org/wiki/Q00000000", "https://ja.wikipedia.org/wiki/○○", "https://twitter.com/example", "https://www.linkedin.com/company/example" ], "knowsAbout": [ "GEO", "SEO", "生成AI最適化", "構造化データ" ] } </script> |
GEO最適化Articleスキーマ
「このコンテンツの信頼性証明書」として機能させるスキーマです。about・mentions・citationを加えることで、トピックの専門性と一次情報性を構造化できます。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 |
<script type="application/ld+json"> { "@context": "https://schema.org", "@type": "Article", "@id": "https://example.com/geo-structured-data/#article", "headline": "GEO構造化データとは?ChatGPT・Geminiに認識されるスキーマ設計ガイド", "description": "GEO構造化データの基本概念から実装方法まで、AI引用を目指すJSON-LD設計を解説します。", "url": "https://example.com/geo-structured-data/", "datePublished": "2026-03-01T09:00:00+09:00", "dateModified": "2026-09-18T09:00:00+09:00", "inLanguage": "ja", "author": { "@type": "Person", "name": "○○ ○○", "url": "https://example.com/author/" }, "publisher": { "@id": "https://example.com/#organization" }, "about": { "@type": "Thing", "name": "GEO構造化データ", "description": "生成AI検索エンジンにコンテンツの意味を伝えるための構造化データ設計手法" }, "mentions": [ { "@type": "Thing", "name": "JSON-LD" }, { "@type": "Thing", "name": "ナレッジグラフ" } ], "citation": [ { "@type": "CreativeWork", "url": "https://schema.org/", "name": "Schema.org" } ] } </script> |
GEO最適化FAQPageスキーマ
FAQPageは、GEO構造化データの中でもAI回答への直接効果が高いスキーマです。answerは質問に答えきった完結文で書きます。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 |
<script type="application/ld+json"> { "@context": "https://schema.org", "@type": "FAQPage", "mainEntity": [ { "@type": "Question", "name": "GEO構造化データとは何ですか?", "acceptedAnswer": { "@type": "Answer", "text": "GEO構造化データとは、ChatGPT・Gemini・PerplexityなどのAI検索エンジンにコンテンツの意味・文脈・信頼性を伝えるためのJSON-LD設計手法です。リッチリザルト表示ではなく、LLMによるエンティティ認識とAI引用を目的とします。" } }, { "@type": "Question", "name": "GEO構造化データでどのスキーマを優先すべきですか?", "acceptedAnswer": { "@type": "Answer", "text": "Organization(エンティティ定義)・Article(信頼性証明)・FAQPage(回答の直接引用)の3つを優先します。特にOrganizationのsameAsにWikidata QIDを含めることが、エンティティ認識の鍵になります。" } } ] } </script> |
BreadcrumbListでサイト構造を伝える
BreadcrumbListはSEO寄りのスキーマとされてきましたが、GEOの文脈では「このページがサイト全体のどこに位置するか」をAIに意味的に伝える役割を持ちます。例えば本記事であれば、GEOハブ配下の構造化データ実装トピックであることをパンくずで明示できます。
|
1 2 3 4 5 6 7 8 9 10 11 |
<script type="application/ld+json"> { "@context": "https://schema.org", "@type": "BreadcrumbList", "itemListElement": [ { "@type": "ListItem", "position": 1, "name": "SEOラボ", "item": "https://example.com/seolaboratory/" }, { "@type": "ListItem", "position": 2, "name": "GEOとは", "item": "https://example.com/seolaboratory/103502/" }, { "@type": "ListItem", "position": 3, "name": "GEO構造化データ", "item": "https://example.com/geo-structured-data/" } ] } </script> |
6. 実装チェックリストとNG例
基盤実装チェック
| チェック項目 | 優先度 | 確認方法 |
|---|---|---|
| Organizationスキーマをサイト全ページに設置 | ★★★ | リッチリザルトテスト |
| sameAsにWikidata QID・Wikipedia URLを含む | ★★★ | JSON-LD目視確認 |
| 全記事にArticleスキーマを設置 | ★★★ | Search Consoleの拡張機能レポート |
| author・publisherが正確に設定されている | ★★★ | リッチリザルトテスト |
| FAQ記事にFAQPageスキーマを設置 | ★★★ | リッチリザルトテスト |
| dateModifiedを更新のたびに書き換えている | ★★☆ | デプロイ後目視確認 |
| Articleスキーマにabout・mentionsを設置 | ★★☆ | JSON-LD目視確認 |
| citationに参考ソースURLを記載 | ★☆☆ | JSON-LD目視確認 |
あわせて、次のようなNG例を避けることで実装品質が上がります。
✕ FAQPageのanswerを「詳しくはこちらをご覧ください」で終わらせる:LLMは回答をそのまま利用する傾向があるため、不完全な回答は引用されにくくなります。
✕ Organizationスキーマをトップページだけに設置する:GEO観点ではどのページからクロールされても同じエンティティ情報が取得できる状態が理想です。
◯ 同一エンティティの情報を全ページで一貫させ、更新のたびにdateModifiedを書き換える:これが最もコストの低い改善策です。
また、sameAsにSNSアカウントのURLだけを設定しているケースも見られますが、GEO観点ではWikidata QIDやWikipedia URLの設定のほうが重要度が高いとされています。SNSのみでは、ナレッジグラフとの接続効果はほとんど期待できません。
「AI検索に引用されたいが、何から始めればいいか分からない」という場合は、SEOラボの無料SEO調査をご利用ください。担当者がサイトを確認し、優先的に改善したいポイントをメールでご案内します。 無料でSEO調査を申し込む
7. まとめ
GEO構造化データは、AIに情報を「見せる」のではなく「意味を渡す」ための設計です。取り組む優先順位は次のとおりです。
- ① Organizationスキーマを全ページに設置:sameAsにWikidata QIDやWikipedia URLを含める。
- ② Articleスキーマでauthor・citationを明示:一次情報性を構造化データで裏づける。
- ③ FAQPageのanswerを完結文にする:LLMがそのまま回答生成に使える形にする。
- ④ dateModifiedを更新のたびに書き換える:情報の鮮度をAIに伝える。
SEO向けスキーマとGEO向けプロパティは競合しません。既存の構造化データを削除する必要はなく、「GEO層を追加する」形で拡張するのが最も効率的です。
GEO全体の戦略や考え方はGEOとは?AI時代の生成エンジン最適化、AI検索対策全体の見取り図はLLMOとはを参照してください。姉妹記事としてPerplexity SEOの実践的対策もあわせてご覧ください。
関連記事
- GEOとは?AI時代の生成エンジン最適化
- LLMOとは?大規模言語モデル最適化の基本とAI検索対策
- AIに引用されるには?AI検索に引用されるためのSEO対策
- E-E-A-Tとは?Googleの評価基準とSEOでの高め方
- Perplexity SEOとは?AI検索に引用されるための実践的対策
FAQ(よくある質問)
Q1. GEO構造化データとSEO構造化データは何が違いますか?
GEO構造化データはChatGPT・GeminiなどのAI検索エンジンにコンテンツの意味と信頼性を伝えることを目的とし、エンティティ定義・sameAsによるナレッジグラフ接続・一次情報性の構造化を重視します。SEO構造化データはGoogleのリッチリザルト表示が目的で、ページ要素の分類が主な役割です。両者は競合しないため、SEOスキーマを維持しながらGEO最適化プロパティを追記する形で両立できます。
Q2. GEO構造化データでどのスキーマを優先すべきですか?
Organization・Article・FAQPageの3つを優先します。特にOrganizationスキーマのsameAsにWikidata QIDやWikipedia URLを含めることが、エンティティ認識の精度に直結します。BreadcrumbListはサイト構造の意味的な伝達に役立ちますが、優先度は上記3つより下がります。
Q3. JSON-LDとMicrodataのどちらがGEOに適していますか?
JSON-LDが適しています。HTMLと分離して管理でき、about・mentions・citationといったGEO向けのプロパティも追加しやすい形式です。Microdataは要素への埋め込み方式のため保守性が下がり、追加プロパティの実装もしにくくなります。
Q4. Wikidataに登録されていなくてもGEO構造化データは有効ですか?
Wikidataへの登録がなくても、Organization・Article・FAQPageの実装自体はGEOの観点で意味を持ちます。ただしsameAsでWikidata QIDを指定できる場合はエンティティ認識の精度が上がるとされているため、Wikidataへのエントリ作成も並行して進めることを推奨します。
Q5. 構造化データを実装すると、どのくらいで効果が出ますか?
GoogleのAI Overviewsへの掲載は、実装後数週間で変化が確認できることがあります。ChatGPTやGeminiへの引用は、モデル側の学習・更新サイクルに影響されるため、数週間〜数カ月単位で評価するのが現実的です。効果測定は、各AI検索での自社ブランド名検索やSearch ConsoleでのAI Overviews掲載URLの確認で行います。
Q6. FAQPageスキーマはすべての記事に設置すべきですか?
FAQ形式のコンテンツを含む記事には設置を推奨しますが、実質的にFAQが存在しない記事に無理に設置しても効果は限定的です。GEO観点では、1ページに5〜10問程度の完結した質問・回答ペアがある場合に効果を発揮しやすいとされています。
この記事の監修者
金田一 健次 きんだいち けんじ
株式会社ディーボ SEO事業部 執行役員 事業部長。2006年入社、SEO・リスティング広告の運用を中心にウェブマーケティングに従事。無料SEOツール群(hanasakigani、aramakijake等)やBULL、キーワードファインダーの開発を主導し、現在はSEO・GEO対策の普及と技術的アプローチの探求に努める。
SEO対策しても検索順位が上がらない…なぜ?
SEO対策しても検索順位が上がらない…なぜ?
検索順位が上がらない理由は、SEO対策の質が低いからです。
例えば、ユーザーの検索意図を無視したり、関連性の低いコンテンツを増やす、内部リンクの最適化など疎かにします。
この場合、SEO対策の質が下がります。
そうなれば、ページやサイト自体の品質が上がらないので、Googleに評価されづらくなります。
結果、検索順位が上がらないというわけです。
こうした悪い状況を回避する為に、サイトの欠点を調査して上位化に必要な対策をご案内します(無料)。
検索順位を上げたり、検索流入を増やすにはSEOが重要!