AIの学習を禁止するrobots.txtの書き方|共通指定と今効く指定
「AIに学習されたくない。でも、検索やAI検索で紹介されるのは残したい」。この両立をrobots.txtでどう書くかは、2026年10月30日を境に答えが変わりました。
結論から言うと、robots.txtにUser-agent: __usage_ai-trainingのグループを作り、Disallow: / と書けば、AIの学習に使わないでほしいと、各社に共通の形で伝えられます。ただし今すぐ読んでいるのはAnthropicだけで、Microsoftは2027年2月1日から、Googleは2027年、OpenAIは数か月以内の対応を目指すとしています。当面は、GPTBotやClaudeBotといった各社のクローラー名での指定と併用します。
注意したいのは、この書き方がまだIETFの正式な標準ではなく、名前が変わる可能性があることです。もう一つ、GoogleのAI OverviewsやAIモードから外す設定はrobots.txtにはなく、Search Consoleにあります。
この記事では、共通の書き方の中身、各社の対応時期、当社サイトに来ているAIクローラーの実測、今すぐ効くrobots.txtの例、Googleの扱い、断る前の注意点を解説します。AI検索とSEOの全体の考え方は「LLMOとは」をご覧ください。
この記事でわかること
- 2026年10月に提案された共通の書き方 __usage_ai-training の中身と、正式な標準ではないこと
- Anthropic・Google・Microsoft・OpenAI がいつから読むか、各社のクローラー名の指定との優先関係
- 学習だけ断って検索用は残す robots.txt の例と、クローラーごとの区分
- Google で AI Overviews・AI モードから外すのは Search Console の設定であること
おすすめの読者層
- AIに学習されたくないが、検索やAI検索での紹介は残したいサイト・メディアの担当者
- GPTBot や ClaudeBot を robots.txt でどう書くか確かめたい方
- 2027年からの共通の書き方に今から備えたい制作会社・出版社の方
2026年10月に提案された「AIの学習を断る共通の書き方」
2026年10月30日、AnthropicのKevin Kelley氏がIETFに草案「Machine-Readable Training Preference Signal」を提出しました。同じ日にGoogle・Microsoft・OpenAIがそれぞれ対応の方針を発表し、各社が同じ書き方を読むと表明したことで、共通の書き方として報じられています。
正式な標準ではない
草案の位置づけは、個人名義で提出されたInternet-Draftです。IETFの承認を受けておらず、AIによる利用の希望の伝え方を扱うAIPREF作業部会で採択された文書でもありません。有効期限は2027年5月3日です。
作業部会のメーリングリストでは、議長の一人であるMark Nottingham氏が2026年11月5日に、作業部会で用意している用語の体系全体をどう付与するかを議論したいと返信しています。追伸では、__usage_ai-trainingという名前は最終形ではなく、サイト運営者を混乱させうるので別の値にすべきだと書いています。作業部会の用語では、この用途はtrain-ai(生成AIモデルの学習に使うこと)です。
つまり、この記事で紹介する書き方は、2026年11月9日時点で各社が読むと表明しているものです。名前が変わったときは、robots.txtを書き直す必要が出ます。
出典:IETF:Machine-Readable Training Preference Signal/IETF ai-controlメーリングリスト:Mark Nottingham氏の返信
robots.txtへの書き方
新しい命令や文法は増えません。robots.txtの標準であるRFC 9309のUser-Agent・Allow・Disallowをそのまま使い、User-Agent行に__usage_ai-trainingと書いたグループで希望を示します。Disallowはその範囲の学習を断り、Allowは認めるという意味です。草案の例は次のとおりです。
|
1 2 3 |
User-Agent: __usage_ai-training Disallow: / Allow: /press-kit/ |
サイト全体の学習を断り、プレスキットのパスだけ認める、という意味になります。パス単位で書き分けられることが、この草案の目的の一つです。名前は大文字小文字を区別しません。
ここで言う「AIの学習」は、草案が参照する作業部会の文書の定義どおり、生成AIモデルのパラメータを変える利用のことです。原文は次のとおりです。
Using an asset to modify the learned parameters of a generative AI model.
検索の順位付けや分類だけに使うモデルの学習は、この定義に含まれません。robots.txtの基本的な書き方は「robots.txtとは」で解説しています。
各社が希望の受け取り口に選んだのはrobots.txtで、llms.txtにこの役割はありません。llms.txtを主要なAIが読みに来ているかは「llms.txtとは?書き方と、AIが本当に読みに来るかを調べた結果」で当社のログを紹介しています。
書かなければ「指定なし」、User-agent: * は一致しない
このグループがrobots.txtにない場合、草案では「何も指定していない」状態です。拒否でも許可でもありません。
見落としやすいのは、User-agent: * のグループがこの名前に一致しない点です。草案は、一致させてはならないと定めています。すべてのクローラーにDisallowを書いていても、学習を断っているとは読まれません。
もう一つ、この名前はクロールの指示ではありません。原文では次のように書かれています。
This policy token is not a directive for crawling behavior.
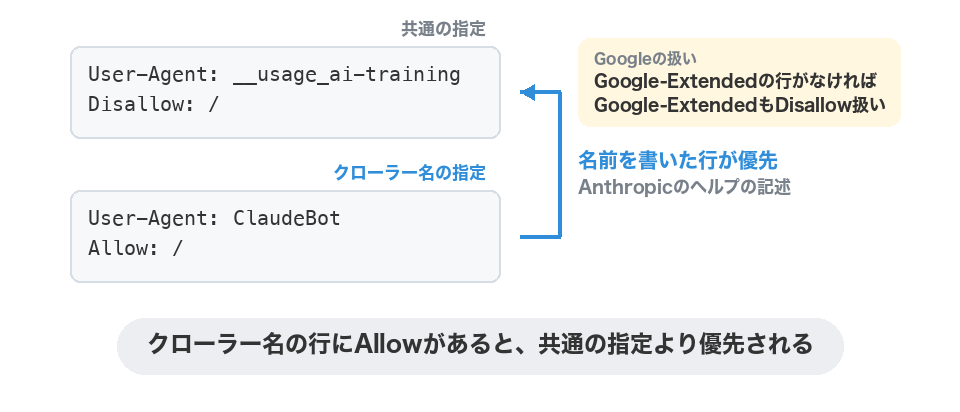
学習を断ってもクローラーは来ます。クロール自体を止めたいときは、従来どおりGPTBotやClaudeBotのようなクローラー名をUser-agentに書きます。草案は、クローラー名による指定と共通の名前による指定を独立したものとして扱い、具体的な指定が優先されるべきだとしています。どちらを具体的と見るかは会社ごとに違います。
各社はいつから従うのか
Anthropic:2026年10月30日から認識を始めている
Anthropicは、クローラーについてのヘルプ記事で、2026年10月30日の時点で学習に使わないでほしいという希望を機械が読める形で受け取り始めたと書いています。IETFの草案に沿ったシグナルです。同じ記事には、ClaudeBotを名指しした行がrobots.txtにあれば一般の設定が違う内容でもそちらに従うこと、ClaudeBotの記載がなければ一般の設定を適用することが書かれています。全サービスへの広げ方は次のとおりです。
We’re rolling this out across all of our services over time and globally, and will provide updates on our progress.
公表されている範囲では、2026年11月9日時点で共通の書き方を実際に読んでいる会社はAnthropicだけです。
出典:Anthropic:Does Anthropic crawl data from the web, and how can site owners block the crawler?
Google:2027年。Google-Extendedが明示されていなければ不許可とみなす
GoogleはSearch Central Blogで、ほかのAI事業者とともに2027年に対応することを目標とし、進捗は更新すると書いています。クローラーの一覧の文書には2027年初めとあり、表現が少し違います。
Google側で重要なのは、既存のGoogle-Extendedとの関係です。原文は次のとおりです。
When a website uses this policy token to opt out of training in its robots.txt file (and Google-Extended is not explicitly specified), Google plans to interpret that as if the publisher had disallowed Google-Extended.
共通の名前で学習を断り、Google-Extendedを明示していなければ、Google-ExtendedをDisallowしたものとして扱う、という内容です。Google-Extendedを明示的に許可しているサイトは、Geminiアプリの回答に表示されクリックを受けられる対象になる、とも書いています。既存のGoogle独自の制御は、新しい共通のシグナルと並行して働き続けます。
出典:Google Search Central Blog:AI training control/Google:Google’s common crawlers
Microsoft:2027年2月1日から。学習とグラウンディングを分けられる
MicrosoftはBingのブログで開始日を明記しています。
Starting February 1, 2027, Microsoft will honor the new preferences as it crawls.
Microsoftの仕組みには、ほかの会社にない区別があります。学習と「グラウンディング」を別の設定で扱う点です。グラウンディングとは、生成AIが回答を作るときの材料としてページを使うことで、従来の検索のインデックスや順位付けはこれに含まれません。
学習についてはrobots.txtの__usage_ai-trainingで、サイト全体かパス単位で書きます。グラウンディングについてはrobots.txtには書けず、ページ単位のmetaタグかHTTPヘッダーで書きます。
|
1 2 3 4 5 |
<meta name="Bingbot" content="ai-training:disallow"> <meta name="Bingbot" content="ai-grounding:disallow"> X-Robots-Tag: Bingbot: ai-training:disallow X-Robots-Tag: Bingbot: ai-grounding:disallow |
ページ単位の学習の設定は、robots.txtの設定より優先されます。どちらも、何も指定していなければ許可が既定です。グラウンディングにはdisallowextendedという値もあります。CopilotやMicrosoft 365など、Microsoft自身のサービスで回答の根拠に使うことは認め、外部の会社に提供するAPIで使うことだけを断れます。
これらは利用についての希望であり、クロールの許可ではありません。Bingbotのクロールをrobots.txtで止めていれば、Allowを書いてもクロールは再開しません。Bingの検索結果に載る資格は、どの設定でも変わらないと明記されています。
これまでNoArchiveやNoCacheで断ってきたサイトは、2027年3月1日以降この2つが学習やグラウンディングの希望として読まれなくなります。制限を続けるなら、それまでにページ単位のai-groundingを公開し、Bing Webmaster Toolsで一時的な設定を登録します。
出典:Bing Blogs:Your content, your choice
OpenAI:数か月以内の対応を目指す
OpenAIも2026年10月30日に発表を出しています。対応は数か月以内を目指し、実装時に詳細を公表するとしています。この時期はITmedia NEWSとSearch Engine Journalの報道で確かめた二次情報です。既存のrobots.txtの方針は引き続き有効で、GPTBotなどの指定を置き換えるものではないとされています。GPTBotの指定と共通の名前が食い違ったときにどちらを優先するかは、発表にもクローラーの文書にも記載がありません。
出典:OpenAI:ウェブサイトがAI学習についての希望を示せるように/OpenAI:Overview of OpenAI Crawlers
二次情報の出典:ITmedia NEWS:各社発表の報道/Search Engine Journal:Google, Microsoft, OpenAI shared AI training opt-out
当社サイトに来ているAIクローラー:30日のアクセス数
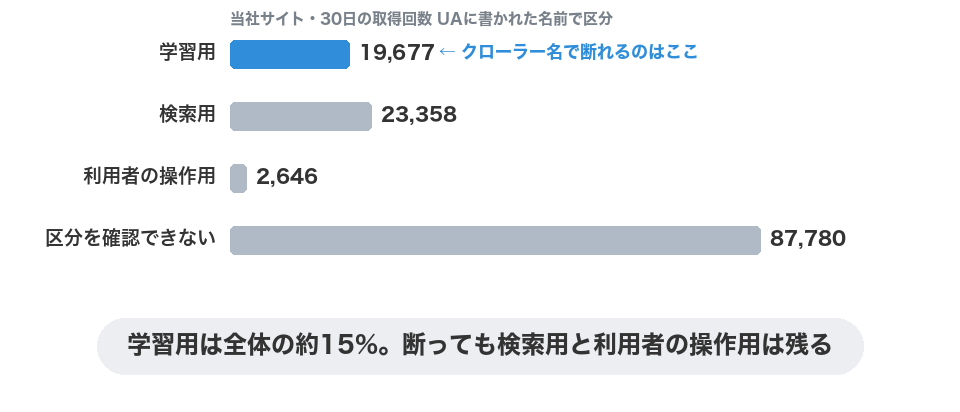
共通の書き方で断れるのは学習だけです。では、サイトに来ているAIクローラーのうち、学習用はどれくらいを占めるのでしょうか。当社サイトdevo.jpのアクセスログで数えました。
対象は2026年10月11日〜11月9日の30日分のSSLアクセスログです。ページ・画像などすべてのリクエストを、ユーザーエージェントに書かれた名前で分けて数えました。区分は各社の公式文書に従い、公式文書で区分を確かめられなかったものは別にまとめています。
| 区分 | UAに書かれた名前 | 取得回数 | 区分の小計 |
|---|---|---|---|
| 学習用 | meta-externalagent | 12,887 | 19,677 |
| ClaudeBot | 4,420 | ||
| GPTBot | 1,874 | ||
| CCBot | 496 | ||
| 検索用 | Applebot | 17,604 | 23,358 |
| PerplexityBot | 3,023 | ||
| OAI-SearchBot | 2,671 | ||
| Claude-SearchBot | 60 | ||
| 利用者の操作用 | Claude-User | 1,411 | 2,646 |
| ChatGPT-User | 1,181 | ||
| Perplexity-User | 54 | ||
| 区分を公式文書で確認できない | Bytespider | 78,520 | 87,780 |
| Amazonbot | 9,113 | ||
| DuckAssistBot | 147 |
CCBotはCommon Crawlの公開データセット用のクローラーで、公式ページはAIの学習に触れていませんが、第三者の学習データの入手元として使われていることから学習用に入れました。meta-externalagentはMetaの文書で学習とインデックスの両方に使うとされています。
合計は133,461回で、学習用は19,677回、全体の約15%でした。クローラー名で学習用をDisallowすると、当社の30日間ではこの約2万回分のアクセスが止まる計算です。検索用の23,358回と、利用者の操作による2,646回は残ります。
最も多かったBytespiderの78,520回は、公式文書で区分を確かめられませんでした。学習用と書いている解説もありますが、一次の文書を当社は見つけていません。robots.txtに従わないという報告が複数あるため、止めたい場合はサーバー側の遮断を併用することになります。
Google-Extendedはこの表にありません。専用のクローラーがなくrobots.txt上の名前だけなので、ユーザーエージェントの数え方では現れないためです。Applebotは検索用の取得で、学習を断る名前であるApplebot-Extendedはクロールしないため、ログにも現れません。
この数字は、当社の1サイト・30日分を、UAに書かれた名前で数えたものです。名前を偽るアクセスは数えられません。
今すぐ効く書き方:クローラーごとの指定
共通の書き方が各社に効くのは、Anthropicを除けば2027年以降です。それまでは、各社のクローラー名で指定します。名前と区分を混同すると、学習を断るつもりで検索からも消えるので、先に一覧で区分を確かめます。2026年11月9日時点の整理です。
| 名前 | 運営元 | 区分 | 止めたときの影響。公式の記述から |
|---|---|---|---|
| GPTBot | OpenAI | 学習 | 学習に使わないでほしいと伝える。各設定は独立 |
| OAI-SearchBot | OpenAI | 検索 | ChatGPTの検索の回答に表示されなくなる |
| ChatGPT-User | OpenAI | 利用者の操作 | robots.txtが適用されない場合がある |
| ClaudeBot | Anthropic | 学習 | 将来の素材を学習データから除外。共通の名前より優先 |
| Claude-SearchBot | Anthropic | 検索 | 検索用のインデックスが止まり、表示されにくくなる可能性 |
| Claude-User | Anthropic | 利用者の操作 | 利用者起点の取得が止まり、表示されにくくなる可能性 |
| Google-Extended | 学習とGeminiのグラウンディング | Google検索の掲載・順位に影響しない。Geminiアプリなどのグラウンディングに使われなくなる | |
| Googlebot | 検索。AI OverviewsやAIモードを含む | Google検索のクロールが止まる | |
| Applebot-Extended | Apple | 学習。クロールしない名前 | 検索結果には引き続き掲載されうる |
| Applebot | Apple | 検索。Spotlight・Siri・Safari | Appleの検索機能から外れると考えられる |
| meta-externalagent | Meta | 学習とインデックス | 両方が止まる。反映に最大24時間 |
| meta-externalfetcher | Meta | 利用者の操作 | robots.txtを迂回しうる |
| CCBot | Common Crawl | 公開データセット | robots.txtで停止できる |
| PerplexityBot | Perplexity | 検索。学習には使わないと明記 | Perplexityの検索に出にくくなる |
| Perplexity-User | Perplexity | 利用者の操作 | robots.txtをおおむね無視すると明記 |
| Bingbot | Microsoft | 検索とAI。学習専用の名前はない | Bingの検索から外れる。学習は__usage_ai-trainingかmetaタグで |
出典:Apple:About Applebot/Meta:Meta Web Crawlers/Common Crawl:CCBot/Perplexity:Perplexity Crawlers。OpenAI・Anthropic・Google・Microsoftは前の節の出典と同じです。
学習だけ断り、検索用は残すrobots.txtの例
表の区分をそのまま書くと、次のようになります。共通の名前のグループを先頭に置き、今すぐ効くクローラー名の指定を続けます。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 |
# 共通の指定。Anthropicは認識開始、Microsoftは2027年2月1日から、Googleは2027年、OpenAIは数か月以内を目指す User-Agent: __usage_ai-training Disallow: / # 今すぐ効くクローラー名の指定。学習用だけ止める User-agent: GPTBot Disallow: / User-agent: ClaudeBot Disallow: / User-agent: Applebot-Extended Disallow: / User-agent: meta-externalagent Disallow: / User-agent: CCBot Disallow: / # 検索用・利用者の操作用は書かない。書かなければ既定で許可 # OAI-SearchBot, Claude-SearchBot, Claude-User, PerplexityBot, Googlebot, Bingbot |
検索用と利用者の操作用のクローラーは書きません。meta-externalagentを止めるとMetaのインデックスも止まるので、Metaでの紹介を残したい場合はこの行を外す判断になります。Google-Extendedはこの例に入れていません。学習とGeminiでの紹介をまとめて扱う名前なので、次の節で別に決めます。
Googleの扱いは別に考える
Google-Extendedは学習とGeminiでの紹介をまとめて制御する
Google-Extendedは、GeminiアプリとVertex AIのGemini APIの将来のモデルの学習と、GeminiアプリやVertex AIのGrounding with Google Searchでのグラウンディングの両方を制御する名前です。Googleの文書は、Google検索への掲載には影響せず、順位のシグナルにも使わないと書いています。
Google-Extended does not impact a site’s inclusion in Google Search
ここから、Googleでは二択になります。Geminiの学習もグラウンディングも断るなら、Google-ExtendedをDisallowします。
|
1 2 |
User-agent: Google-Extended Disallow: / |
Geminiアプリでの紹介とクリックを残したいなら、Google-ExtendedをAllowと明示します。明示がないと、共通の名前のDisallowでGoogle-Extendedも不許可の扱いになるからです。
ただしAllowと明示した場合、Google-Extendedは学習とグラウンディングを一つの名前で扱うため、Geminiの学習も許可することになると当社は読んでいます。Googleが「学習だけ断り、Geminiでの紹介は残す」という分け方を用意しているという記述は、公式文書に見つけていません。Microsoftがページ単位で分けられるのと、ここが違います。
AI OverviewsやAIモードから外すのはSearch Consoleの設定
Google検索のAI OverviewsやAIモードに御社のページが使われないようにしたい、という要望は、共通の名前でもGoogle-Extendedでも実現しません。Googleはこの用途に、Search Consoleの「Search generative AI」コントロールを用意しています。2026年6月3日に発表され、当初は英国の一部サイトでのテストでしたが、2026年8月31日に全世界のすべてのサイトに展開されました。
対象はAI Overviews、AIモード、Google Discoverの生成AI機能です。ヘルプには、このコントロールは検索のほかの部分の順位や掲載のシグナルには使われないこと、AIの学習には影響しないことが明記されています。学習を制限するならGoogle-Extended、検索から完全に消すならnoindex、と役割を分けて案内しています。場所はSearch Consoleの設定にあるSearch generative AIで、反映はコントロールが有効になってから1〜2日とされ、キャッシュなどで遅れることがあります。
外すと、AI OverviewsやAIモードからの表示とクリックはなくなります。表示される条件は「AI Overviewsに表示される条件とは」で解説しています。
出典:Google:New controls for website owners/Search Consoleヘルプ:Search generative AI
断る前に知っておきたい注意点
- ClaudeBotにAllowを書いていると、共通の名前より優先される:クロールを許可するつもりでUser-agent: ClaudeBotにAllow: / を書いているサイトがあります。AnthropicはClaudeBotを名指しした行を優先すると書いているので、共通の名前でDisallowしてもClaudeBotのAllowが生き、学習を断れない、と読めます。これはAnthropicの記述からの推論です。クローラー名の指定と共通の名前の指定は、同じ内容になるようにそろえます
- Cloudflareの「Training」ブロックは、Googlebot・Applebot・Bingbotも止める:Cloudflareは2026年7月1日から、無料プランを含む全顧客に、AIのアクセスをSearch・Agent・Trainingの区分で止める設定を開放しています。Trainingをブロックすると、最も厳しい規則を適用するため、Googlebot・Applebot・BingBotのような複数の用途を持つクローラーも止まるとCloudflare自身が書いています。Trainingを一律に止めると、検索からの流入を失う恐れがあります
- すでに取得された内容は消えない:適用されるのは、取得した時点のrobots.txtの内容です。これまでに取得され、学習に使われた内容を取り消す働きはありません
- 利用者の操作による取得にはrobots.txtが効かないことがある:ChatGPT-User・Perplexity-User・meta-externalfetcherのように、利用者の質問に応じて取得するものには、robots.txtが適用されない場合があると各社が明記しています。robots.txtは希望を伝える手段で、強制力はありません
- AI検索での紹介まで止めると、見つけてもらいにくくなる:OAI-SearchBotやClaude-SearchBot、PerplexityBotまで止めると、各AI検索で表示・引用されにくくなると各社が書いています。当社は、AI検索をSEOの延長と考えています。学習を断るかどうかと、検索やAI検索で見つけてもらうかどうかは別の判断で、止める対象は学習用に絞るのが基本です。AIに引用されるための書き方は「AIに引用されやすくなる記事の書き方」で解説しています
出典:Cloudflare:Your site, your rules: new AI traffic options for all customers/Cloudflare Changelog:New options to manage AI traffic
AIの学習を断るときのよくある質問
Content-SignalやContent-Usageという行も見かけます。同じものですか
別の書き方です。Content-Signalは、Cloudflareが管理するrobots.txtの先頭に付けている行で、search=yes,ai-train=no,use=referenceのように書きます。Content-Usageは、IETFのAIPREF作業部会が進めている付与方式の草案にある行で、HTTPヘッダーのContent-Usage: train-ai=nや、robots.txtのContent-Usage: /ai-ok/ train-ai=yのように書きます。
__usage_ai-trainingは、この作業部会の作業への提案として提出されたもので、作業部会の文書そのものではありません。2026年11月9日時点で各社が読むと表明しているのは__usage_ai-trainingです。Cloudflareが管理するrobots.txtには、__usage_ai-trainingへの言及がありません。
出典:IETF:Attaching AI Preferences
古い解説にあるanthropic-aiやClaude-Webは書いたほうがよいですか
現行のAnthropicのヘルプに載っているクローラーは、ClaudeBot・Claude-User・Claude-SearchBotです。anthropic-aiとClaude-Webは載っていません。学習を断る目的ならClaudeBotを書きます。古い名前の行が残っていても現行のクローラーには関係がなく、それだけでは希望が伝わりません。
まとめ:御社のrobots.txtを開いて確かめる手順
まず https://御社のドメイン/robots.txt をブラウザで開き、次の点を見ます。
- User-agent: * のDisallowだけで、学習を断ったつもりになっていないか
- GPTBot・ClaudeBot・Applebot-Extended・meta-externalagent・CCBotの行があり、Disallowになっているか
- ClaudeBotにAllowを書いていないか
- Google-Extendedをどうするか決めて、明示しているか
- __usage_ai-trainingのグループを足したか
AI OverviewsやAIモードから外したい場合は、robots.txtとは別にSearch Consoleの設定を開きます。サーバーのアクセスログがあれば、次のように数えて、当社の表と同じ区分で御社の数字を見られます。
|
1 2 3 |
grep -c "ClaudeBot" access.log grep -c "GPTBot" access.log grep -c "OAI-SearchBot" access.log |
学習用の回数と検索用の回数を並べれば、断ったときに何が止まり何が残るかが、御社の数字で見えます。
この記事の監修者
金田一 健次 きんだいち けんじ
株式会社ディーボ 執行役員。2006年入社、SEO・リスティング広告の運用を中心にウェブマーケティングに従事。無料SEOツール群(hanasakigani、aramakijake等)やBULL、キーワードファインダーの開発を主導し、現在はSEO・GEO対策の普及と技術的アプローチの探求に努める。
記事を増やしても検索順位が上がらない…なぜ?
記事を増やしても検索順位が上がらない…なぜ?
順位が上がらない原因は、新しく足すものではなく、これまで作ってきたページの中にあることがあります。
例えば、同じ内容のページが複数のURLで存在している、サイト内のページ同士が同じキーワードを奪い合っている、Googleに認識されていないページがある、といった状態です。
こうした問題は、サイトを運用している側ほど気づきにくいものです。
ご依頼のURLをもとにサイト全体を調べ、見直すべき箇所と直す順番を無料でお伝えします。
- « 前の記事
llms.txtとは?書き方と、AIが本当に読みに来るかを調べた結果 - 次の記事 »
検索順位を上げたり、検索流入を増やすにはSEOが重要!