JSON-LDとは?構造化データの書き方と実装手順・テスト方法
「構造化データを入れておいて」と頼まれて調べ始めると、JSON-LD・schema.org・リッチリザルトと言葉ばかり増えていく。WordPressのプラグインが何かを出しているらしいが、中身が正しいのかは分からない。この場面で手が止まる方は少なくありません。
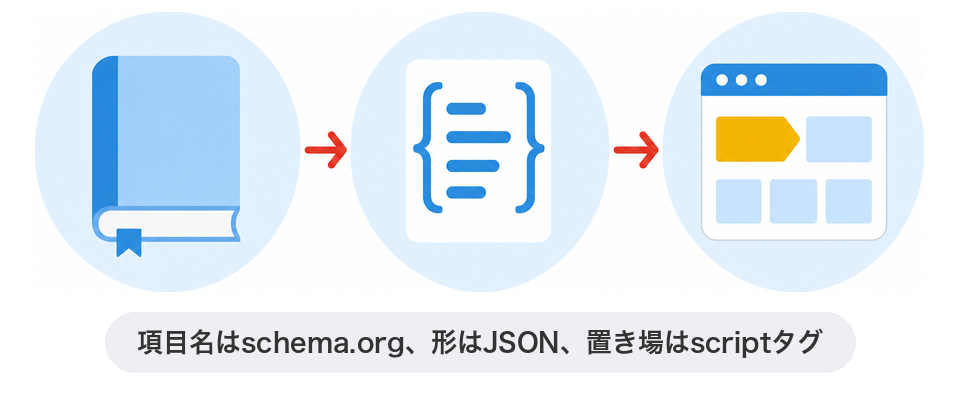
結論から言うと、JSON-LDは、ページの内容をschema.orgで決められた項目名で書いたJSONを<script type=”application/ld+json”>タグに入れる記法です。Googleが推奨し、headとbodyのどちらにも置けます。
書く・テストする・Search Consoleで見張る、の3段で運用すれば、入れたつもりで壊れている状態を防げます。
今回は、JSON-LDの文法、記事・パンくず・組織・人物のコード例、WordPressやタグマネージャーでの実装、リッチリザルトテストとSearch Consoleでの確認方法、2026年に表示が終わった型までを解説します。コード例には、SEOラボが実際に出力しているJSON-LDを使いました。
構造化データそのものの考え方は「構造化データとは?メリットや種類・マークアップ・ツール」、パンくずリストの基本は「パンくずリストとは?SEO効果などWebサイトの基本」で解説しています。この記事が解説するのは「JSON-LDをどう書き、どう確かめるか」です。
この記事でわかること
- JSON-LDの文法と、@context・@type・@id・@graphの役割
- 記事・パンくず・組織・人物のJSON-LDの書き方と実例
- WordPressやタグマネージャーで入れるときの注意点
- リッチリザルトテストとSearch Consoleで確認する手順
- 2026年に表示が終わったFAQなどの型と、今も有効な型
おすすめの読者層
- サイトに構造化データを入れたいWeb担当者
- プラグインが出すJSON-LDの正しさを確かめたい人
- 構造化データのエラーをSearch Consoleで指摘された人
JSON-LDとは
JSON-LDとは、JSON for Linked Dataの略で、schema.orgで決められた項目名で表したページの情報をJSONの形で書く記法です。構造化データの「書き方」の1つであり、何を書くかはschema.orgが、どう書くかはJSON-LDが決めます。
似た言葉を役割で分けると、次のようになります。
- 構造化データ:ページの内容を検索エンジンが読める形で書いたデータそのもの(中身)
- schema.org:Article・Organizationなど、何を書くかを決めた共通の項目名の一覧(辞書のようなもの)
- JSON-LD:その項目名を使い、JSONの形でHTMLに埋め込む記法(書き方)
- リッチリザルト:構造化データを元にGoogleが検索結果に出す拡張表示(結果)
SEOラボでは、全記事のJSON-LDをWordPressのテーマ側で出力しています。1つのscriptタグに、Organization・WebSite・WebPage・BreadcrumbList・Article・Person(監修者)の6つの型をまとめて書く構成です。
この記事のコード例は、その本番出力から取りました。ちなみに当社ツール aramakijake.jpによるGoogleの月間推定検索数(2026年10月8日調べ)では、「JSON-LD」の検索は「構造化データ」より大きく、「書き方」まで付けたキーワードはごく小さいです。
| キーワード | Google月間推定検索数 |
|---|---|
| JSON-LD | 11,840 |
| schema.org | 9,680 |
| 構造化データ | 2,320 |
| リッチリザルト | 1,920 |
| 構造化データ 書き方 | 32 |
| JSON-LD 書き方 | 8 |
出典:当社ツール aramakijake.jp によるGoogleの月間推定検索数(2026年10月8日調べ)
JSONとJSON-LDの違いとschema.orgとの関係
JSONはデータを「キーと値」の組で書く汎用の形式で、JSON-LDはそのJSONに「この値はArticleのheadlineだ」という意味を付けたものです。意味を付ける役目を果たすのが、後述する@contextと@typeです。
注意したいのは、schema.orgの項目をGoogleがすべて使うわけではない点です。Googleは「Google 検索の動作の定義には、schema.org のドキュメントではなく、Google 検索セントラルのドキュメントを使用してください」と書いています。
どの型に何を書くかは、Google検索セントラルの各機能のページで確かめます。
出典:構造化データの仕組みについて(Google検索セントラル)
Googleが推奨する理由とMicrodata・RDFaとの違い
構造化データの記法はJSON-LD・Microdata・RDFaの3つがあり、Googleが推奨するのはJSON-LDです。理由として「ウェブサイトの所有者が実装と管理を最も容易に行うことができる(つまり、ユーザーエラーの発生する可能性が低い)」と書かれています。
MicrodataとRDFaは本文のHTMLタグに属性を足す方式なので、デザインを変えるとマークアップが崩れやすく、入れ子の情報も書きづらくなります。JSON-LDは本文と分かれているので、テンプレートで一括管理できるというわけです。
| 記法 | 書く場所 | 本文のHTMLと混ざるか | 入れ子の書きやすさ | Googleの推奨 |
|---|---|---|---|---|
| JSON-LD | headまたはbodyのscriptタグ | 混ざらない | 書きやすい | 推奨 |
| Microdata | 本文のHTMLタグの属性(通常はbody) | 混ざる | タグの入れ子に依存する | 可 |
| RDFa | 本文のHTMLタグの属性(headとbody) | 混ざる | タグの入れ子に依存する | 可 |
Googleは、JavaScriptでページに動的に挿入されたJSON-LDも読み取ると書いています。CMSやタグマネージャー経由で入れる方法が成り立つのは、この記述が根拠です。
当社がX公式アカウントの投票で行ったアンケート(2025年10月1〜10日、計250人)でも、構造化データの記法はJSON-LDを採用した方が75%でした。実務でJSON-LD以外を選ぶ理由は、ほとんどありません。
出典:構造化データの仕組みについて(Google検索セントラル)
JSON-LDの基本の書き方
JSON-LDは、最小の形を覚えてから、値の形式・@id・@graphの順に積み上げると迷いません。最小の形は、scriptタグ・@context・@type・プロパティの4要素です。
scriptタグと@contextと@type
次が、組織(Organization)を表す最小のJSON-LDです。
|
1 2 3 4 5 6 7 8 |
<script type="application/ld+json"> { "@context": "https://schema.org", "@type": "Organization", "name": "株式会社ディーボ", "url": "https://devo.jp/" } </script> |
- <script type=”application/ld+json”>:中身がJSON-LDであることを伝えるタグ。ブラウザは実行せず無視する
- @context:使う項目名の出どころ。Google検索向けはschema.orgに固定する
- @type:schema.orgの型名。大文字小文字を区別する(organizationでは認識されない)
- name・url:型ごとに決まったプロパティ。キーも値もダブルクォートで囲む
Googleは機能ごとに必須プロパティと推奨プロパティを定義し、「少数であっても完全で正確な推奨プロパティを提供するほうが重要です」と書いています。当社も、本文にない情報を推奨プロパティの穴埋めのために足すことはしません。
プロパティの値の形式
JSON-LDのエラーの多くは、値の形式の間違いです。例えば日付を “2026/10/20” と書く、URLを相対パスにする、数値を引用符で囲む、といったものです。
| 値の種類 | 正しい例 | よくある間違い |
|---|---|---|
| 文字列 | “headline”: “JSON-LDとは” | シングルクォートで囲む/キーを引用符で囲まない |
| 数値 | “width”: 1280 | “1280” と文字列にする |
| 日付・時刻 | “datePublished”: “2026-10-20T10:00:00+09:00” | “2026/10/20″。タイムゾーンを省く |
| URL | “url”: “https://devo.jp/seolaboratory/” | “/seolaboratory/” のような相対パス |
| 真偽値 | “isAccessibleForFree”: true | “true” と文字列にする |
| 入れ子 | “image”: { “@type”: “ImageObject”, “url”: “https://…” } | 閉じ括弧の数が合わない |
| 配列 | “sameAs”: [ “https://x.com/…”, “https://www.facebook.com/…” ] | 最後の要素の後ろに余分なカンマを残す |
日付はISO 8601形式で、日本のサイトなら末尾に +09:00 を付けます。URLは https:// から始まる絶対URLにします。正しい形式を1つにまとめると次のとおりです。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 |
{ "@context": "https://schema.org", "@type": "Article", "headline": "JSON-LDとは", "datePublished": "2026-10-20T10:00:00+09:00", "dateModified": "2026-10-20T10:00:00+09:00", "mainEntityOfPage": "https://example.com/json-ld/", "image": [ "https://example.com/images/json-ld.png" ], "isAccessibleForFree": true, "wordCount": 11000 } |
@idで要素を結び付ける
@idは、JSON-LDの中の要素に付ける名前です。@idを付けた要素は、別の要素から { “@id”: “…” } と書くだけで参照できます。記事の著者と組織、ページとパンくずリストのように、同じページの中で複数の型がつながるときに使います。
Googleのガイドラインも、ページ上に複数のアイテムがある場合は@idでリンクするよう書いています。「アイテムをリンクしないと、動画をレシピのリッチリザルトとして表示できることが Google 検索で認識できません」という説明です。
@idの値は、ページURLに #organization のようなハッシュを付けた形が一般的です。Googleは2024年1月9日に、ドキュメント内のコード例の@id参照をすべてハッシュ付きに変更しました。当社もこの形に合わせています。
出典:構造化データに関する一般的なガイドライン(Google検索セントラル)/検索セントラル ドキュメントの最新情報(2024年1月9日)
複数の型を1ページに書く
1ページに複数の型を書く方法は、scriptタグを型ごとに分ける方法と、1つのscriptの中で@graphという配列に並べる方法があります。Googleはどちらでも認識します。
SEOラボは@graphにまとめる方式です。値を省いて、型とつながりだけを示すと次のとおりです。6つの要素が@idでつながっています。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 |
{ "@context": "https://schema.org", "@graph": [ { "@type": "Organization", "@id": "https://devo.jp/#organization", "name": "株式会社ディーボ", "url": "https://devo.jp/" }, { "@type": "WebSite", "@id": "https://devo.jp/#website", "url": "https://devo.jp/", "publisher": { "@id": "https://devo.jp/#organization" } }, { "@type": "WebPage", "@id": "https://devo.jp/seolaboratory/91744/#webpage", "url": "https://devo.jp/seolaboratory/91744/", "isPartOf": { "@id": "https://devo.jp/#website" }, "breadcrumb": { "@id": "https://devo.jp/seolaboratory/91744/#breadcrumb" }, "reviewedBy": { "@id": "https://devo.jp/seolaboratory/author/kindaichi/#person" } }, { "@type": "BreadcrumbList", "@id": "https://devo.jp/seolaboratory/91744/#breadcrumb" }, { "@type": "Article", "@id": "https://devo.jp/seolaboratory/91744/#article", "isPartOf": { "@id": "https://devo.jp/seolaboratory/91744/#webpage" }, "author": { "@id": "https://devo.jp/#organization" }, "publisher": { "@id": "https://devo.jp/#organization" } }, { "@type": "Person", "@id": "https://devo.jp/seolaboratory/author/kindaichi/#person", "name": "金田一 健次" } ] } |
この構成には、当社の設計意図が入っています。記事の著者(Article.author)は編集部として組織を指し、監修者(WebPage.reviewedBy)は個人のPersonを指す、という分け方です。本文の「執筆:編集部、監修:個人」の表示と同じ関係を、JSON-LDでも再現しています。
@graphとscript分割のどちらを選ぶかは、管理のしやすさで決めてよいと当社は考えています。ただしテーマとプラグインの両方が構造化データを出す環境では、scriptを分けた方が「どの出力がどこから来たか」を見つけやすいです。
ページの種類別のJSON-LDの実例
Googleがサポートする構造化データの機能は、2026年10月時点で検索ギャラリーに25種類あります。ここでは、ほぼすべてのサイトに関係する記事・パンくずリスト・組織・人物(プロフィールページ)に絞って、SEOラボの本番の値で示します。
商品・ローカルビジネス・求人情報などは、必要なサイトだけが使う型です。必須・推奨プロパティは検索ギャラリー(Google検索セントラル)から各機能のページで確認してください。
記事(Article)
記事の構造化データに必須プロパティはなく、推奨はheadline・image・datePublished・dateModified・author(name・url)です。画像は「アスペクト比が 16×9、4×3、1×1 の高解像度画像(幅と高さをかけて 50,000 ピクセル以上になる画像)」が条件です。
著者はPersonかOrganizationを正しく選び、複数の著者は配列で1人ずつ分けて書きます。SEOラボの記事「SEOとは」のArticle要素は次のとおりです。@graphの中にあるので、@contextはscriptの先頭に1回だけ書いてあります。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 |
{ "@type": "Article", "@id": "https://devo.jp/seolaboratory/91744/#article", "isPartOf": { "@id": "https://devo.jp/seolaboratory/91744/#webpage" }, "author": { "@id": "https://devo.jp/#organization" }, "publisher": { "@id": "https://devo.jp/#organization" }, "headline": "【2026年最新】SEOとは?仕組みや基本の対策、AI検索との関係を初心者にもわかりやすく解説", "datePublished": "2024-08-19T09:10:35+09:00", "dateModified": "2026-10-05T10:10:08+09:00", "mainEntityOfPage": "https://devo.jp/seolaboratory/91744/#webpage", "image": { "@id": "https://devo.jp/seolaboratory/91744/#primaryimage" } } |
headlineは本文のタイトル、2つの日付はWordPressの公開日時と更新日時、imageはWebPage側で定義した1280×720pxのアイキャッチを@idで参照しています。本文に表示している値と1つも違わないことが、Articleで守る点です。
出典:記事(Article、NewsArticle、BlogPosting)の構造化データ(Google検索セントラル)
パンくずリスト(BreadcrumbList)
パンくずリストは、2つ以上のListItemを持つBreadcrumbListで表します。各ListItemにはposition(順番)・name(表示名)・item(URL)を書き、最後の要素のitemは省略できます。この場合、Googleはそのページ自身のURLを使います。
Googleは「URL 構造をそのまま反映させるのではなく、ユーザーが特定のページにたどり着くまでの一般的な経路を示すことをおすすめします」と書いています。SEOラボの記事は、会社トップ→SEOラボ→SEOの記事一覧→記事、の4階層です。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 |
{ "@type": "BreadcrumbList", "@id": "https://devo.jp/seolaboratory/91744/#breadcrumb", "itemListElement": [ { "@type": "ListItem", "position": 1, "item": { "@type": "WebPage", "@id": "https://devo.jp/", "url": "https://devo.jp/", "name": "株式会社ディーボ" } }, { "@type": "ListItem", "position": 2, "item": { "@type": "WebPage", "@id": "https://devo.jp/seolaboratory/", "url": "https://devo.jp/seolaboratory/", "name": "ディーボのSEOラボ" } }, { "@type": "ListItem", "position": 3, "item": { "@type": "WebPage", "@id": "https://devo.jp/seolaboratory/seotaisaku/", "url": "https://devo.jp/seolaboratory/seotaisaku/", "name": "SEOの記事一覧" } }, { "@type": "ListItem", "position": 4, "item": { "@type": "WebPage", "@id": "https://devo.jp/seolaboratory/91744/", "url": "https://devo.jp/seolaboratory/91744/", "name": "【2026年最新】SEOとは?仕組みや基本の対策、AI検索との関係を初心者にもわかりやすく解説" } } ] } |
itemはURLの文字列を直接書いても構いません。SEOラボではWebPage型のオブジェクトにして、@idとnameを持たせています。パンくずリストの設計は「パンくずリストとは」で解説しています。
出典:パンくずリスト(BreadcrumbList)の構造化データ(Google検索セントラル)
組織(Organization)
組織の構造化データは、ホームページか会社概要のような1ページに置けば足ります。Googleは「サイトのすべてのページに含める必要はありません」と書いています。必須プロパティはなく、name・url・logo・sameAs・address・contactPointなどが推奨です。
logoの画像は「112×112 ピクセル以上にする必要があります」とあり、URLはクロール可能でなければなりません。sameAsには、公式SNSなど同じ組織を指す他のページのURLを配列で書きます。SEOラボの記事の実際の出力は次のとおりです。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 |
{ "@type": "Organization", "@id": "https://devo.jp/#organization", "name": "株式会社ディーボ", "url": "https://devo.jp/", "sameAs": [ "https://x.com/devojpinc" ], "logo": { "@type": "ImageObject", "@id": "https://devo.jp/#logo", "url": "https://devo.jp/images/devo-logo-square-180.png", "width": 180, "height": 180, "caption": "株式会社ディーボ" }, "image": { "@id": "https://devo.jp/#logo" } } |
これに所在地と連絡先を足した推奨形は次のようになります。ドメインと値は例です。住所と電話番号は会社概要ページに表示しているものと同じにし、ロゴは112×112px以上の画像を用意します。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 |
{ "@context": "https://schema.org", "@type": "Organization", "@id": "https://www.example.com/#organization", "name": "株式会社Example", "url": "https://www.example.com/", "logo": "https://www.example.com/images/logo-600x600.png", "sameAs": [ "https://x.com/example", "https://www.facebook.com/example" ], "address": { "@type": "PostalAddress", "postalCode": "060-0000", "addressRegion": "北海道", "addressLocality": "札幌市中央区", "streetAddress": "北1条西1丁目1-1", "addressCountry": "JP" }, "contactPoint": { "@type": "ContactPoint", "contactType": "customer service", "telephone": "+81-120-000-000", "availableLanguage": "Japanese" } } |
出典:組織(Organization)の構造化データ(Google検索セントラル)
人物とプロフィールページ(Person・ProfilePage)
著者や監修者の紹介ページには、ProfilePageを使います。必須プロパティはmainEntityで、そのページが誰(Person)または何(Organization)についてのページかを示します。
記事側のauthorやreviewedByからこのPersonの@idを参照すれば、記事と人物がつながります。SEOラボの監修者ページの出力は次のとおりです。パンくずリストの要素は省いています。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 |
{ "@context": "https://schema.org", "@graph": [ { "@type": "ProfilePage", "@id": "https://devo.jp/seolaboratory/author/kindaichi/#page", "url": "https://devo.jp/seolaboratory/author/kindaichi/", "name": "監修者プロフィール 金田一健次", "mainEntity": { "@id": "https://devo.jp/seolaboratory/author/kindaichi/#person" }, "isPartOf": { "@id": "https://devo.jp/#website" } }, { "@type": "Person", "@id": "https://devo.jp/seolaboratory/author/kindaichi/#person", "name": "金田一 健次", "alternateName": "Kenji Kindaichi", "jobTitle": "執行役員", "worksFor": { "@type": "Organization", "@id": "https://devo.jp/#organization", "name": "株式会社ディーボ", "url": "https://devo.jp/" }, "image": "https://devo.jp/seolaboratory/images/author/kindaichi.jpg", "url": "https://devo.jp/seolaboratory/author/kindaichi/", "knowsAbout": [ "SEO", "GEO", "ウェブマーケティング", "SEOツール開発", "リスティング広告" ] } ] } |
記事側のWebPage.reviewedByが指す@idと、このページのPersonの@idは同じ文字列です。ページをまたいで同じ人物であることを伝えるには、@idを揃えるのがいちばん確実です。
当社は2026年8月21日に全記事に監修者の表示とreviewedByのPersonを導入し、9月17日には記事ごとに監修者を切り替えられるようテーマを改修しました。運用のルールは1つで、JSON-LDに書く監修者は本文の監修者ボックスに表示している人物に限ります。
監修者や著者の情報がE-E-A-Tの評価でどう扱われるかは「E-E-A-T(旧E-A-T)とは」で解説しています。
出典:プロフィール ページ(ProfilePage)の構造化データ(Google検索セントラル)
JSON-LDをサイトに実装する方法
書き方は同じでも、サイトへの入れ方によって注意する点が変わります。静的HTML・WordPress・Googleタグマネージャー(JavaScript)の3つの経路に分けて、どこに書き何を確認するかを示します。
静的HTMLや自前のテンプレートに書く
HTMLファイルを直接編集できるサイトでは、headかbodyの中に<script type=”application/ld+json”>を置くだけです。Googleはどちらに置いても読み取るので、テンプレートで管理しやすい場所を選んでください。
注意が要るのは、タイトル・日付・URLなどの変数を埋め込むときです。文字列の連結でJSONを組むと、タイトルにダブルクォートや改行が1つ入っただけでJSON全体が無効になります。
なので、言語に用意されたJSONエンコードの関数(PHPのjson_encode、JavaScriptのJSON.stringifyなど)に配列やオブジェクトを渡して出力します。エスケープを関数に任せれば、どんなタイトルでも壊れません。
WordPressで実装する
WordPressでJSON-LDを出す方法は、テーマ(functions.phpやsingle.php)で出力する、SEOプラグイン(AIOSEO・Yoast SEOなど)に任せる、本文のカスタムHTMLブロックに直接書く、の3通りです。テーマで出すなら、wp_json_encodeを使います。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 |
<?php $data = array( '@context' => 'https://schema.org', '@type' => 'Article', 'headline' => wp_strip_all_tags( get_the_title() ), 'datePublished' => get_the_date( 'c' ), 'dateModified' => get_the_modified_date( 'c' ), 'mainEntityOfPage' => get_permalink(), 'image' => array( get_the_post_thumbnail_url( null, 'full' ) ), 'author' => array( '@type' => 'Organization', 'name' => '株式会社ディーボ', 'url' => 'https://devo.jp/', ), ); echo '<script type="application/ld+json">' . wp_json_encode( $data, JSON_UNESCAPED_UNICODE | JSON_UNESCAPED_SLASHES ) . '</script>'; ?> |
get_the_date( ‘c’ ) はタイムゾーン付きのISO 8601形式を返します。JSON_UNESCAPED_UNICODEは日本語をそのまま出すための指定で、付けなくてもJSONとしては正しく読まれます。
プラグインで出す場合に多いのが、テーマとプラグインの両方が同じ型を出す二重出力です。例えばArticleが2つあって日付が食い違うと、Googleがどちらを使うか分かりません。片方に寄せてください。
本文のカスタムHTMLブロックに書く方法は、当社はおすすめしません。投稿者の権限や保存の経路によってWordPressがscriptタグを除去することがあり、記事ごとに手書きすると更新日や監修者の変更に追従できないからです。
当社の運用では、記事の本文にJSON-LDを書かず、テーマとカスタムフィールドで一元管理しています。ちなみにこの記事のコード例も、WordPressが有効なJSON-LDとして解釈しないよう、タグを実体参照にして載せています。
WordPress全体の設定は「WordPressのSEO対策ですべきこと」をご覧ください。
GoogleタグマネージャーやJavaScriptで挿入する
HTMLを直接触れないサイトでは、Googleタグマネージャー(GTM)のカスタムHTMLタグでJSON-LDを挿入できます。Googleは「Google 検索によるページのレンダリング時に、DOM 内の有効な構造化データが認識され、処理されます」と書いています。
GTMでは、タイトルやURLをタグの中に直書きせず、変数で取ります。「GTM に情報を複製すると、ページ コンテンツと GTM で挿入した構造化データとの間に不整合が生じるリスクが高まる」というのがGoogleの理由です。カスタムHTMLの最小例は次のとおりです。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 |
<script type="application/ld+json"> { "@context": "https://schema.org", "@type": "Article", "headline": "{{page_title}}", "mainEntityOfPage": "{{Page URL}}", "author": { "@type": "Organization", "name": "株式会社Example", "url": "https://www.example.com/" } } </script> |
{{page_title}} は、document.title を返すカスタムJavaScript変数として定義します。値にダブルクォートが入ると壊れるのは静的HTMLと同じなので、変数側で引用符を取り除くか、JSON.stringifyで組んだ文字列をまるごと挿入する方式にします。
Googleは商品(Product)について、動的生成がGoogleショッピングのクロールの頻度と信頼性を下げる可能性があると書いています。在庫や価格が頻繁に変わるECサイトでは、サーバー側で出力する方が確実です。
出典:JavaScript を使用して構造化データを生成する(Google検索セントラル)
JSON-LDのテスト方法とよくあるエラー
Googleは「開発中はリッチリザルト テストを使用して構造化データをテストし、デプロイ後はリッチリザルトのステータス レポートを参照して、構造化データの有効性を確認してください」と書いています。理由は、テンプレートや配信の仕方が原因で、公開後にページの正常性が損なわれることがあるからです。
つまり、公開前のテストで合格しても終わりではありません。公開後のSearch Consoleでの監視まで含めて、はじめて実装が完了するというわけです。
リッチリザルトテストとSchema Markup Validator
リッチリザルトテストは、Google検索で表示される可能性のあるリッチリザルトを確認する公式ツールです。公開済みのURLを入れる方法とコードを貼り付ける方法があり、スマートフォンとパソコンのユーザーエージェントを選べます。
結果には「エラー」と「警告」が出ます。エラーは必須プロパティの欠落や構文の誤りで、リッチリザルトの対象になりません。警告は推奨プロパティの欠落で、対象から外れはしませんが、表示される情報の質に関わります。
注意したいのは、このツールが見るのはGoogleがサポートする機能だけだという点です。WebSite・WebPage・Personだけのページや、サポートが終わった型は「アイテムが検出されませんでした」になります。これは構文エラーではありません。
Googleがサポートしない型も含めて、schema.orgのルールとして正しいかを確かめるにはSchema Markup Validatorを使います。Googleは「すべての種類の schema.org マークアップをテストします。この際、Google 固有の検証は行われません」と使い分けを書いています。
当社の使い分けは、Googleの機能に関わる型はリッチリザルトテスト、@graph全体の構文と型名の確認はSchema Markup Validator、という形です。両方で問題がなければ公開に進めます。
出典:リッチリザルト テスト(Search Console ヘルプ)/構造化データをテスト(Google検索セントラル)
Search Consoleのリッチリザルトレポートと修正の検証
公開後は、Search Consoleの「拡張」にあるリッチリザルトの各レポートで、Googleが実際にクロールしたページの状態を見ます。レポートは、Googleがそのプロパティで有効なマークアップを検出し、かつサポートされている型である場合にだけ表示されます。
項目は「有効」と「無効」に分かれ、無効なアイテムには「リッチリザルトとして表示できないようにする重大な問題」があります。重大でない問題は「検索での見え方を改善できるアイテム」として別の表に出ます。数値はページ数ではなくアイテム数です。
直したら、問題の詳細ページで「修正を検証」を押し、Googleに再クロールを依頼します。急ぐ場合はURL検査ツールで個別にインデックス登録をリクエストします。Search Console全体の使い方は「Googleサーチコンソールとは」で解説しています。
出典:リッチリザルト レポートの概要(Search Console ヘルプ)
複数ページをまとめて確認する方法
テンプレートで出しているJSON-LDは、1ページで合格しても、別の記事のタイトルや画像の有無で壊れることがあります。当社は本番公開の前後に、対象ページのHTMLからすべてのld+jsonブロックを抜き出し、JSONとしてパースできるかを機械的に確かめています。
手順は、URLの一覧を作る、各ページのHTMLからld+jsonブロックを抜き出す、JSONパーサーに通して失敗したURLだけを並べる、で足ります。値が本文と一致しているかは、数本だけリッチリザルトテストで見れば済みます。
よくあるエラーと直し方
| 症状 | 原因 | 直し方 |
|---|---|---|
| 「構文にエラーがある構造化データが検出されました」 | カンマ・引用符・括弧の閉じ忘れ。キーが引用符で囲まれていない | JSONパーサーに通す。テンプレートならJSONエンコード関数で出力する |
| 「値の型が正しくありません」 | 数値を文字列にしている。配列が必要な所に文字列を書いている | 各機能のドキュメントの型定義(Text・Integer・URL・DateTime)に合わせる |
| URLや画像が認識されない | 相対パス。画像がrobots.txtでブロックされている | 絶対URLにする。URL検査ツールで画像URLのクロール可否を見る |
| 同じ型が2つ検出される | テーマとプラグインの二重出力。旧テンプレートの残骸 | 出力元を1つにする。ソースでld+jsonブロックの数を数える |
| 必須プロパティの欠落(エラー) | BreadcrumbListのposition・name・item、ProfilePageのmainEntityなど | 該当機能のドキュメントの必須プロパティを揃える |
ガイドライン違反と手動による対策
Googleのガイドラインでは「ページの読者に表示されないコンテンツをマークアップしないでください」とされています。JSON-LDに書いた人物・評価・質問は、本文にも同じ内容がなければなりません。
違反すると、構造化データに関する手動による対策を受け、そのページはリッチリザルトとして表示されなくなります。ただしGoogleは「Google ウェブ検索でのページの掲載順位には影響しません」とも明記しています。
当社が構造化データの正確さを最優先にするのは、手動による対策を避けるためだけではありません。本文と違う値を渡すことは、ページの理解を助けるという構造化データの目的に反します。
出典:構造化データに関する一般的なガイドライン(Google検索セントラル)
終了したリッチリザルトと今サポートされている型
JSON-LDの解説記事には、FAQページ(FAQPage)やハウツー(HowTo)のコード例が今も多く載っています。しかし、どちらもGoogle検索での表示は終了しています。何がいつ終わったかを、Google検索セントラル「最新情報」の掲載日で整理します。
| 最新情報の掲載日 | 対象 | 内容 |
|---|---|---|
| 2023年9月14日 | ハウツー(HowTo) | 表示されなくなったためドキュメントを削除。FAQは政府機関・保健衛生関連サイトのみ表示と記載 |
| 2024年11月29日 | サイトリンク検索ボックス | ドキュメントを削除 |
| 2025年4月23日 | 特別なお知らせ | サポート終了の通知を追加 |
| 2025年6月12日 | 書籍アクション・コース情報・給与推定額・ClaimReview・学習用動画・特別なお知らせ・車両リスティング | 廃止予定のバナーを追加 |
| 2025年9月9日 | コース情報・給与推定額・学習用動画・特別なお知らせ・車両リスティング | ドキュメントを削除 |
| 2025年11月5日 | 練習問題・データセット・書籍アクション | 練習問題にサポート終了通知。データセットはデータセット検索のみと明記。書籍アクションは終了バナーを撤回 |
| 2026年1月6日 | 練習問題 | ドキュメントを削除 |
| 2026年5月8日 | よくある質問(FAQ) | サポート終了の通知を追加。2026年5月7日以降Google検索に表示されない |
| 2026年6月15日 | よくある質問(FAQ) | ドキュメントを削除 |
出典:検索セントラル ドキュメントの最新情報(Google検索セントラル)(2026年10月8日確認)
検索ギャラリーの現行一覧の読み方
今サポートされている型は、検索ギャラリーに一覧があります。2026年10月8日時点で、記事・パンくずリスト・組織・プロフィールページ・商品・ローカルビジネス・求人情報・イベント・動画・レシピ・Q&A・ディスカッションフォーラムなど25の機能が載っており、FAQとハウツーは含まれていません。
この一覧に載っていない型は、書いてもリッチリザルトにはなりません。ページの理解を助ける目的でWebSiteやWebPageを書くことは、別の話です。
FAQPageとHowToのマークアップをどうするか
Googleが書いているのは、表示が終わったことと、ドキュメントを削除した理由までです。既に出しているFAQPageを残した場合の不利益は、Googleのドキュメントには書かれていません。
当社の判断は、表示が終わった型のために新しくマークアップを書く必要はない、既に出しているものは本文と一致している限り急いで外さなくてもよく、本文を更新するときに一緒に見直す、というものです。
当社のSEOラボでも、新しくFAQPageを足すことはしていません。この記事の「よくある質問」も、構造化データを付けずに本文だけで載せています。
出典:検索セントラル ドキュメントの最新情報(2026年5月8日・6月15日)
JSON-LDのSEO効果とAI検索との関係
構造化データが順位に使われるかどうかは「構造化データとは」で解説しているので、ここでは要点だけにします。
順位に直接は使われない
構造化データの役目は、リッチリザルトの表示資格を得ることと、Googleがページの内容を誤解しないよう補助することです。Googleも「構造化データが検索結果に表示されるとは限りません」と書いており、正しく実装しても表示は保証されません。
当社のアンケート(X公式アカウントの投票、2025年10月1〜10日、計250人)では、著者情報を構造化データでマークアップしている理由は「E-E-A-T対策として積極的に実施している」が46.3%で最多でした。
当社も記事ごとの監修者をPersonで出していますが、順位を上げるためではありません。本文に表示している監修者の情報を、検索エンジンにも同じ形で渡すためです。構造化データは「本文の正確な写し」であり、本文にない価値を足すものではない、というのが当社の考えです。
AI OverviewsやAIモードで必要になること
GoogleはAI Overviews(AIによる概要)やAIモードについて「別途特別な最適化を行う必要もありません」と書いています。「特別な schema.org の構造化データを追加する必要もありません」とも明記され、求められているのは「構造化データをページに表示されるテキストと一致させる」ことです。
当社は、AI検索への対策はSEOの延長で本質は変わらないと考えています。JSON-LDについても、AI向けの特別な型を探すのではなく、本文と一致した正確な構造化データを出し続けることが対策になります。
AI Overviewsに表示される条件は「AI Overviewsに表示される条件とは」、AIに引用されることを意識したスキーマの設計は「GEO構造化データとは」で解説しています。
出典:AI 機能とウェブサイト(Google検索セントラル)/構造化データに関する一般的なガイドライン(Google検索セントラル)
JSON-LDのよくある質問
JSON-LDはheadとbodyのどちらに書けばいいですか
どちらでも読まれます。Googleは、JSON-LDはHTMLの<head>と<body>の<script>タグ内に埋め込めると書いています。テンプレートで一括管理しやすい場所を選んでください。当社はテーマのhead内で出力しています。
1ページに複数の型を書いてもいいですか
書けます。scriptタグを型ごとに分けても、1つのscriptの中で@graphに並べても、Googleは認識します。避けるのは同じ型を2つ出すことで、関連する要素は@idで結び付けます。
プラグインが出しているJSON-LDをそのまま使ってもいいですか
使えますが、確認が必要です。リッチリザルトテストにURLを入れて、検出された型と値が本文と一致しているか、同じ型が2つ出ていないかを見てください。プラグインの既定値(著者がサイト名になっているなど)は、そのサイトの事実と違うことがあります。
FAQPageのマークアップはもう外すべきですか
新しく書く必要はありません。既に出しているものは、本文と一致している限り急いで外す必要はないと当社は考えています。Googleのドキュメントには、残すことによる不利益は書かれていません。本文を更新するときに一緒に見直してください。
構造化データを入れると順位は上がりますか
直接は上がりません。得られるのはリッチリザルトの表示資格と、Googleがページの内容を正しく理解する助けです。詳しくは「構造化データとは」で解説しています。
まとめ:JSON-LDは書いて終わりではなくテストと監視で運用する
JSON-LDは、schema.orgで決められた項目名で書いたページの情報を、<script type=”application/ld+json”>タグの中にJSONの形で置く記法です。Googleが推奨し、headとbodyのどちらにも置け、JavaScriptで挿入したものも読まれます。
書くときは@context・@typeから始め、値の形式を守り、複数の型は@idで結び付けます。入れる経路が何であっても、本文と同じ値をJSONエンコードの関数で出す、という原則は変わりません。公開前と公開後の確認は次の項目で足ります。
- 公開前:すべてのld+jsonブロックがJSONとしてパースでき、リッチリザルトテストでエラーがない
- 公開前:headline・日付・著者・画像・パンくずが本文の表示と一致している
- 公開前:同じ型が2つ出ておらず、表示が終わった型を新しく足していない
- 公開後:Search Consoleのリッチリザルトレポートに無効なアイテムがない
- 公開後:本文を更新したとき、JSON-LDの値(更新日・監修者・パンくず)も追従している
構造化データの表示は保証されませんが、壊れたままの状態は確実に機会を失います。書く・テストする・見張る、の3段を習慣にしてください。
- 構造化データとは?メリットや種類・マークアップ・ツールなど初心者にわかりやすく解説!
- パンくずリストとは?SEO効果などWebサイトの基本を徹底解説!
- SEO内部対策とは?施策やチェックリスト25項目など徹底紹介!
- テクニカルSEOとは?コンテンツSEOとの違いや施策などわかりやすく解説!
- GEO構造化データとは?AIに引用されるスキーマ実装
- AI Overviewsに表示される条件とは?表示されない理由
- WordPressのSEO対策ですべきこと!必須の設定など初心者にわかりやすく解説
- E-E-A-T(旧E-A-T)とは?SEOで重要なGoogleの評価基準など徹底解説!
- Googleサーチコンソールとは?使い方や設定など基本を初心者向けに解説!
この記事の監修者
金田一 健次 きんだいち けんじ
株式会社ディーボ 執行役員。2006年入社、SEO・リスティング広告の運用を中心にウェブマーケティングに従事。無料SEOツール群(hanasakigani、aramakijake等)やBULL、キーワードファインダーの開発を主導し、現在はSEO・GEO対策の普及と技術的アプローチの探求に努める。
記事を増やしても検索順位が上がらない…なぜ?
記事を増やしても検索順位が上がらない…なぜ?
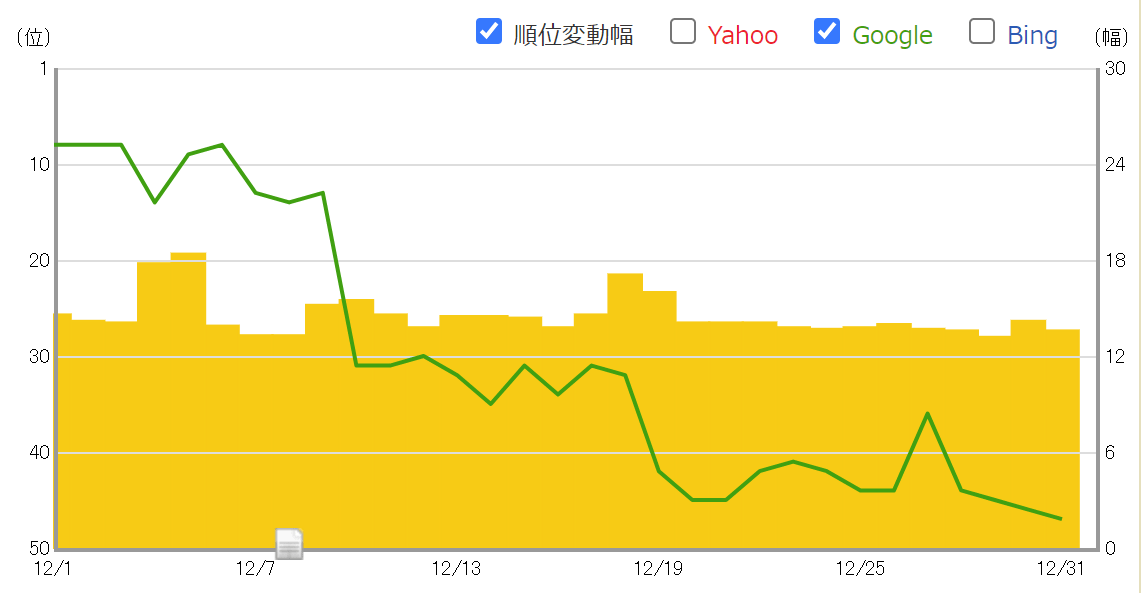
順位が上がらない原因は、新しく足すものではなく、これまで作ってきたページの中にあることがあります。
例えば、同じ内容のページが複数のURLで存在している、サイト内のページ同士が同じキーワードを奪い合っている、Googleに認識されていないページがある、といった状態です。
こうした問題は、サイトを運用している側ほど気づきにくいものです。
ご依頼のURLをもとにサイト全体を調べ、見直すべき箇所と直す順番を無料でお伝えします。
- « 前の記事
SEOコンサルティングとは?費用相場・依頼の流れ・失敗しない選び方を徹底解説! - 次の記事 »
検索順位を上げたり、検索流入を増やすにはSEOが重要!