JavaScript SEOとは?Googleが読める範囲を実際に検証
「サイトをJavaScriptで作り直すと、Googleに読まれなくなる」。制作会社やシステム部門からReactなどの名前が出てきたとき、こう聞いて不安になる方は多いはずです。一方で「今のGoogleはJavaScriptを実行するから問題ない」という説明も目にします。
結論から言うと、GoogleはJavaScriptを実行してページを読みます。ただし、HTMLだけのページとは違い、レンダリングという追加の段階を通るため、作り方によっては読まれない部分が出ます。Googleは公式ドキュメントで「Google 検索は JavaScript を最新バージョンの Chromium で実行します」と書いています。
この記事では、Googleがどこまで読めるのかを、公式ドキュメントの記述と、当社がテストページで実際に確かめた結果で示します。あわせて、読まれにくくなる作り方と直し方、レンダリング方式の選び方、Search Consoleで自分のサイトを確かめる手順を解説します。
なお、この記事で扱うのはGoogle検索だけです。他の検索エンジンやAIのクローラーには触れません。
この記事でわかること
- GoogleがJavaScriptのページをクロール・レンダリング・インデックス登録の順で処理する流れと、HTMLだけのページとの違い
- 当社の検証で、JavaScriptで追加した本文・リンク・JSON-LDのうち、レンダリング後のHTMLに残ったもの・残らなかったもの
- hrefのないリンク、無限スクロール、遅延読み込みなど、Googleに読まれにくくなる作り方と直し方
- Search ConsoleのURL検査で自分のサイトを確かめる手順と、開発側への伝え方
おすすめの読者層
- ReactなどJavaScriptでサイトやサービス画面を作った(作る予定の)Web担当者で、「JavaScriptはSEOに不利」と聞いて不安な方
- 順位が伸びないページがJavaScriptで表示されており、それが原因かどうかを自分で確かめたいSEO担当者
- SSRや動的レンダリングを採用すべきか、開発側に何を伝えればよいかを判断したい方
GoogleはJavaScriptのページをどう処理するか
Googleの公式ドキュメントには「Google は、JavaScript ベースのウェブアプリを 3 つの主要なフェーズで処理します。1. クロール 2. レンダリング 3. インデックス登録」と書かれています。HTMLだけのページと違うのは、真ん中にレンダリングが入ることです。順に見ていきます。
クロール:まずHTMLだけを取得する
Googlebotは、URLにアクセスしてサーバーが返したHTMLを取得します。この時点ではJavaScriptは実行されていません。この記事では、サーバーが返したHTMLを初期HTMLと呼びます。初期HTMLに本文やリンクが書かれていれば、Googleはこの段階でそれを読めます。
反対に、本文もリンクもJavaScriptが後から書き込む作りなら、この段階でGoogleが読める本文はありません。また、Googlebotが取得するのはファイルの最初の2MBまでです。JavaScriptのファイルが極端に大きいと、その先は切り捨てられます。
レンダリング:JavaScriptを実行してページを組み立てる
取得したページは、レンダリングの待ち行列に入ります。Googleはこの待ち行列をキューと呼び、「ページはこのキューで数秒間(またはそれ以上)待機することがあります。」と書いています。順番が来ると、Chromiumを使ってJavaScriptを実行し、ユーザーがブラウザで見るのと近い状態のHTMLを作ります。この記事では、これをレンダリング後のHTMLと呼びます。
クロールとレンダリングの間には、この時間差があります。初期HTMLに本文がないページは、レンダリングが済むまでGoogleに本文を認識されません。
レンダリングが行われない場合もあります。「Google が noindex タグを検出した場合は、レンダリングと JavaScript の実行がスキップされる可能性があります。」とあるため、初期HTMLにnoindexを置いてJavaScriptで外す、という作りは成り立ちません。後の検証でテストページにnoindexを付けなかったのも、この記述が理由です。
インデックス登録:レンダリング後のHTMLを読む
レンダリング後のHTMLから本文・リンク・構造化データを読み取り、インデックスに登録します。JavaScriptで追加された本文やリンクは、ここで初めて読まれます。
次の節で、当社のテストページを使い、レンダリング後のHTMLに何が残ったかを示します。
出典:JavaScript SEO の基本を理解する/Googlebot
当社の検証:Googleがレンダリング後に読めたもの・読めなかったもの
公式ドキュメントの記述を、当社のサイトに置いたテストページで確かめました。知りたかったのは、JavaScriptで追加した本文やリンクのうち、何がレンダリング後のHTMLに残るかです。
検証の条件
- 実施日:2026年10月15日と16日の2回。同じ手順で行い、結果は2回とも同じだった
- テストページ:当社サイトに置いた静的HTML1ページ。JavaScriptはフレームワークや外部ライブラリを使わず記載。サイト内からはリンクせず、noindexは付けていない
- 確認方法:Search ConsoleのURL検査で「公開URLをテスト」→「テスト済みのページを表示」→「HTML」タブを開き、レンダリング後のHTMLを取得
- 判定:項目ごとに固有の確認用の文字列を用意し、レンダリング後のHTMLにその文字列があるかを検索した
確認用の文字列は、スクリプトの中にそのまま書くと追加されていなくてもHTMLの検索で見つかるため、実行時に組み立てて追加する形にしました。
対照として、通常のChromeでも同じページを開き、画面の高さ934pxのまま操作せずに22秒待ちました。ボタン・画面に入ったとき・スクロール量を条件にした本文だけが、操作しないと表示されませんでした。
テストページの要点を抜き出すと、次のような作りです。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 |
<!-- 1. HTMLに最初から書いた本文(対照用) --> <p>(確認用の文字列)</p> <!-- 4. ボタンを押したときだけ出る本文 --> <button id="btn">続きを表示</button> <!-- 10. 画面に入ったときに追加する目印(ページのかなり下に置く) --> <div id="far-below"></div> <script> function add(text) { var p = document.createElement('p'); p.textContent = text; document.body.appendChild(p); } // 2. 読み込み時に追加 document.addEventListener('DOMContentLoaded', function () { add('(確認用の文字列)'); }); // 3. 3秒後・10秒後・20秒後に追加 setTimeout(function () { add('(確認用の文字列)'); }, 3000); setTimeout(function () { add('(確認用の文字列)'); }, 10000); setTimeout(function () { add('(確認用の文字列)'); }, 20000); // 4. ボタンを押したときだけ追加 document.getElementById('btn').addEventListener('click', function () { add('(確認用の文字列)'); }); // 10. 目印が画面に入ったときに追加 new IntersectionObserver(function (entries) { if (entries[0].isIntersecting) add('(確認用の文字列)'); }).observe(document.getElementById('far-below')); // 11. スクロール量が一定を超えたときに追加 window.addEventListener('scroll', function () { if (window.scrollY > SCROLL_THRESHOLD) add('(確認用の文字列)'); }); </script> |
検証の結果
結果は次のとおりです。○はレンダリング後のHTMLに確認用の文字列が残ったこと、×は残らなかったことを示します。
| No. | 項目 | 作り方 | レンダリング後のHTMLに残ったか | 補足 |
|---|---|---|---|---|
| 1 | HTMLに最初から書いた本文 | 静的なpタグ(対照用) | ○ | — |
| 2 | 読み込み時にJSで追加した本文 | ページを開いた直後にJavaScriptで文章を追加 | ○ | — |
| 3a | 3秒後にJSで追加した本文 | ページを開いて3秒後に文章を追加 | ○ | — |
| 3b | 10秒後にJSで追加した本文 | ページを開いて10秒後に文章を追加 | × | — |
| 3c | 20秒後にJSで追加した本文 | ページを開いて20秒後に文章を追加 | × | — |
| 4 | ボタンを押したときだけ出る本文 | ボタンのクリックで文章を追加 | × | — |
| 5 | hrefのあるリンク | 静的なaタグ(対照用) | ○ | — |
| 6 | onclickだけのリンク(hrefなし) | aタグにhrefを付けず、クリック時にJavaScriptで移動 | 文字は残る | hrefがないため、リンクのURLとしては取り出せない |
| 7 | 別ファイルから取得して追加した本文 | 同じサイトのJSONファイルをfetchで取得し、文章を追加 | ○ | サーバーのログにも、Googleの検査ツールがJSONファイルを取得した記録があった |
| 8 | JSで書き換えたtitle・meta description | 初期HTMLと異なる値をJavaScriptで設定 | ○ | 書き換え後の値になっていた |
| 9 | JSで作ったhrefのあるリンク | JavaScriptでaタグを生成し、hrefにURLを入れて追加 | ○ | — |
| 10 | 画面に入ったときに追加した本文 | ページの下の方(1,800px以上下)に置いた目印が画面に入ったら文章を追加(IntersectionObserver) | ○ | 通常のブラウザでは、スクロールしないと表示されない位置 |
| 11 | スクロール量を条件に追加した本文 | scrollイベントで、スクロール量が一定を超えたら文章を追加 | × | — |
| 12 | JSで挿入したJSON-LD | JavaScriptでscriptタグ(application/ld+json)を追加 | ○ | — |
結果から分かったこと
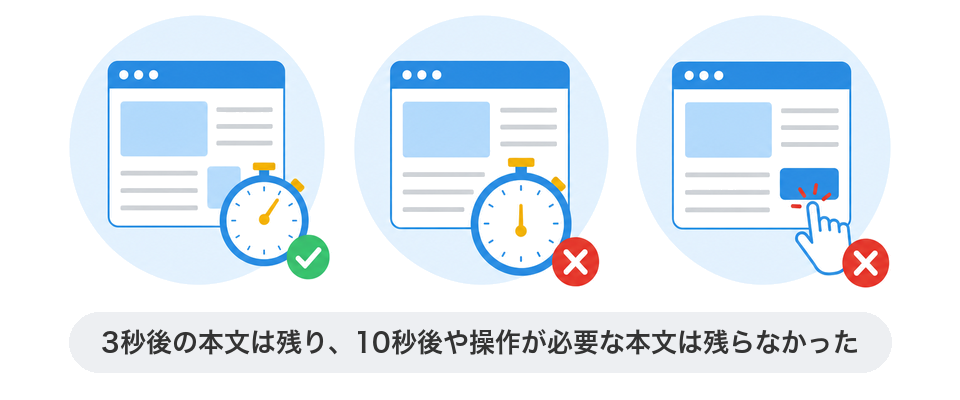
残らなかったのは、10秒後・20秒後に追加した本文、ボタンを押したときだけ出る本文、スクロール量を条件にした本文の4行です。ページを開いた直後に追加した本文、href付きで作ったリンク、挿入したJSON-LDは残りました。別ファイルをfetchで取得して追加した本文も残り、サーバーのログにはGoogleの検査ツールがそのJSONファイルを取りに来た記録がありました。レンダリングの途中で別ファイルを読みに行く作りでも、取得できる状態なら本文は組み立てられます。
見落としやすいのは、onclickだけで移動するリンクです。リンクの文字はレンダリング後のHTMLに残りました。ただしaタグにhrefがないため、Googleがたどる先のURLはどこにも書かれていません。本文を検索すると残っているように見えて、リンク先としては取り出せない状態です。同じJavaScriptで作ったリンクでも、hrefを付けた9番はURLごと残りました。6番と9番を分けたのは、読まれない原因がJavaScriptで作ったことなのか、hrefがないことなのかを切り分けるためです。
時間の条件では、3秒後に追加した本文は残り、10秒後・20秒後は残りませんでした。3秒・10秒・20秒に分けたのは、Googleがどこまで待つかの手がかりを得るためです。公式ドキュメントの「数秒間(またはそれ以上)」はレンダリングの待ち行列に入っている時間の記述で、JavaScriptの実行を何秒待つかは書かれていません。今回の条件では3秒は残り10秒は残らなかった、という事実の範囲で受け取ってください。
ページのかなり下に置いた目印が画面に入ったら追加する作りは、通常のブラウザではスクロールしないと表示されない位置なのに残りました。スクロール量を条件にした作りは残っていません。ユーザーの目にはどちらも下まで見ると出てくる動きですが、Googleは縦に長い画面でレンダリングしているとみられ、スクロールの操作はしません。遅延読み込みの説明にある「Google検索はページ上での操作を行わない」のとおりです。
ただし、検証は2回だけです。2回とも同じ結果でしたが、ページの作りや時期によって変わる可能性があります。また、この結果が示すのはレンダリング後のHTMLに残ったことまでで、インデックスされたかどうかはこの方法では分かりません。ライブテストはリンク先をたどらないため、リンク先のページが取得されたかどうかも同じです。
Googleに読まれにくくなる作り方と直し方
実際のサイトで見かける作り方を、症状ごとに分けて示します。
hrefのないリンク:onclick・javascript:void(0)・routerLink
次の例は、どれもGoogleがリンク先のURLを取り出せない書き方です。JavaScriptで画面を移動させていても、Googleはたどれません。
|
1 2 3 4 5 6 7 8 9 10 11 12 |
<!-- NG: hrefがない --> <a onclick="location.href='/products/1234/'">商品の詳細</a> <!-- NG: a以外の要素にhrefを付けている --> <span href="/products/1234/">商品の詳細</span> <!-- NG: hrefの中身がURLではない --> <a href="javascript:goTo('/products/1234/')">商品の詳細</a> <a href="javascript:void(0)" onclick="goTo(1234)">商品の詳細</a> <!-- NG: フレームワーク独自の属性だけで、レンダリング後もhrefがない場合 --> <a routerLink="/products/1234">商品の詳細</a> |
共通点は、aタグにURLの入ったhrefがないことです。Googleは「href 属性のない a 要素や、スクリプト イベントによりリンクとして機能するタグから URL を信頼できる形で抽出することはできません」と書いています。一覧から詳細ページへのリンクがこの形だけだと、Googleは詳細ページへたどれません。当社検証のNo.6がこの状態でした。
直し方は、aタグにURLの入ったhrefを付けることです。JavaScriptで画面を切り替える場合も、hrefは残します。
|
1 2 3 4 5 |
<!-- OK: hrefにURLがある --> <a href="/products/1234/">商品の詳細</a> <!-- OK: hrefを残して、JavaScriptの動きを重ねる --> <a href="/products/1234/" onclick="goTo(1234); return false;">商品の詳細</a> |
フレームワーク独自のリンク部品を使っている場合も、確認は同じです。レンダリング後のHTMLで、該当のaタグにURLの入ったhrefがあるかを見ます。内部リンクの設計全体は「内部リンク」の記事で解説しています。
クリックやスクロールをしないと出ないコンテンツ:無限スクロール・「もっと見る」・タブ
例えば、商品一覧が最初に20件だけ表示し、下までスクロールするたびに次の20件を読み込む作りだとします。この作りでは、Googleが21件目以降の商品を見つけられない可能性があります。「もっと見る」ボタンで続きを出す一覧も、タブの中身をクリック後に取得する作りも同じです。Googleは「Google のクローラーはボタンを「クリック」せず、通常、現在のページ コンテンツを更新するためにユーザーの操作が必要となる JavaScript 関数のトリガーもしません。」と書いています。当社検証でボタンとスクロール量の本文が残らなかったのもこのためです。
直し方は、無限スクロールの裏側にページ分けを用意することです。Googleは「チャンクごとに永続的かつ固有のURLを設定」するよう求めています。URLは ?page=12 のような絶対的なページ番号にし、?date=yesterday のような相対的な指定は避けます。各ページは通常のaタグのhrefでつなぎます。
|
1 2 3 4 5 6 7 8 9 10 11 |
<!-- 一覧の各ページに固有のURLを持たせる --> https://example.com/products/?page=1 https://example.com/products/?page=2 https://example.com/products/?page=3 <!-- 各ページに、前後のページへのリンクをhrefで置く --> <a href="/products/?page=1">前のページ</a> <a href="/products/?page=3">次のページ</a> <!-- NG: 相対的な指定。日によって中身が変わる --> https://example.com/products/?date=yesterday |
ユーザーにはスクロールで次が出る体験を残しつつ、URLの上では2ページ目・3ページ目が存在する形です。かつて使われたrel=”next”・rel=”prev”について、Googleは「今後はこれらのタグを使用しません」と書いているため、これを付けるだけでは代わりになりません。
タブや「もっと見る」で隠れている本文は、初期HTMLに含めたうえで表示だけを切り替える作りなら、レンダリング後のHTMLに残るので読まれます。ページ分けのURL設計は「ページネーション」の記事で解説しています。
画像・本文の遅延読み込み(lazy load)
遅延読み込みを使っているページは、URL検査のレンダリング後のHTMLで、ページの下の方にある本文や画像のURLが入っているかを見てください。入っていなければ、読み込みの条件を疑います。Googleは、関連するコンテンツがビューポートに表示されるタイミングで読み込まれるように実装することを求め、方法として「IntersectionObserver API と ポリフィル を使用する」ことを挙げています。当社検証のとおり、この方法は残り、スクロール量を条件にした方法は残りませんでした。
|
1 2 3 4 5 6 7 8 9 10 11 12 |
// NG: スクロールのイベントを条件にする。Googleはスクロールしない window.addEventListener('scroll', function () { if (window.scrollY > 1000) loadMore(); }); // OK: 要素が画面に入ったことを条件にする var observer = new IntersectionObserver(function (entries) { entries.forEach(function (entry) { if (entry.isIntersecting) loadMore(); }); }); observer.observe(document.getElementById('more')); |
画像については、imgタグのloading=”lazy”属性が使えます。ブラウザに組み込まれた遅延読み込みで、JavaScriptに依存せず、src属性に画像のURLが入ったままです。
出典:遅延読み込みコンテンツを修正する/JavaScript SEO の基本を理解する
URLのフラグメント(#)で画面を切り替える
https://example.com/#/products のように、「#」の後ろでページを切り替えるサイトがあります。古いシングルページアプリケーション(SPA)でよく使われた作りです。Googleは「フラグメントを使用して別のページ コンテンツを読み込まないでください」と書いています。「#」の後ろはページ内の位置を指すものとして扱われ、別のページにはなりません。
2015年にAJAXクロールの仕組みが廃止されて以降、この形は非対応です。直し方は、History APIを使って通常のURLで切り替えることです。
|
1 2 3 4 5 6 |
<!-- NG: フラグメントで別のページを表示する --> https://example.com/#/products/1234 https://example.com/#!/products/1234 <!-- OK: 通常のURL。History API(pushState)で切り替える --> https://example.com/products/1234/ |
出典:JavaScript SEO の基本を理解する/Google 検索における JavaScript の問題を解決する
CookieやlocalStorage、ユーザーへの許可に依存する
前回の訪問で選んだ地域を記憶して表示する、位置情報の許可を得てから店舗一覧を出す、といった作りは、Googlebotには成り立ちません。公式ドキュメントには、ローカルストレージとセッションストレージのデータ、HTTP Cookieはページ読み込み時にクリアされると書かれており、「Googlebot はユーザーへのアクセス許可リクエストを拒否するものと考えます」ともあります。
Googlebotが見るのは、何も保存されていない状態のページです。許可や保存値がなくても主要な本文が表示される、既定の状態を用意してください。
出典:Google 検索における JavaScript の問題を解決する
robots.txtでJS・CSSを拒否している/存在しないページがHTTP 200を返す
robots.txtでJavaScriptやCSSのファイルを拒否していると、レンダリングに必要なファイルを取得できず、本文が欠落します。読み込めなかったファイルは、URL検査の「ページのリソース」に出ます。
存在しないURLでも200を返す作りも、シングルページアプリケーションで起きがちです。どのURLでも同じHTMLを返し、JavaScript側で「ページが見つかりません」と表示すると、Googleはソフト404として扱います。Googleは「有意なステータス コードを使用します」とし、対処として、サーバーが404を返すURLにリダイレクトするか、noindexのメタタグを追加する方法を挙げています。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 |
// NG: 存在しない商品でも200のまま「見つかりません」を表示する // OK(案1): サーバーが404を返すURLへ移動する fetch('/api/products/' + id).then(function (res) { if (res.status === 404) { window.location.href = '/not-found'; } }); // OK(案2): noindexのmetaタグをJavaScriptで追加する var meta = document.createElement('meta'); meta.name = 'robots'; meta.content = 'noindex'; document.head.appendChild(meta); |
robots.txtやステータスコードの基本は「クローラビリティ」の記事で解説しています。
出典:Google 検索における JavaScript の問題を解決する/JavaScript SEO の基本を理解する
レンダリング方式の選び方:CSR・SSR・静的生成・動的レンダリング
ここまでの問題の多くは、本文がいつHTMLに入るかで決まります。サーバーが返す初期HTMLに本文が入っていれば、Googleはレンダリングを待たずに本文を読めます。ブラウザでJavaScriptを実行してはじめて本文が入る作りなら、レンダリングの完了を待つことになります。この違いを生むのが、レンダリング方式です。
| 方式 | 本文がHTMLに入るタイミング | Googleの処理 | 向くサイトの例 | 注意点 |
|---|---|---|---|---|
| クライアントサイドレンダリング(CSR) | ブラウザでJavaScriptを実行した後 | レンダリング待ちが要る | ログイン後の管理画面など、検索からの流入を想定しない画面 | 初期HTMLは空に近い。この記事の注意点がすべて当たる |
| サーバーサイドレンダリング(SSR) | サーバーの初回応答 | 初期HTMLで本文を読める | 商品一覧・記事など、検索からの流入を狙うページ | サーバーの処理と構成が増える |
| 静的生成(ビルド時にHTML化) | サーバーの初回応答(あらかじめ生成したHTMLを返す) | 初期HTMLで本文を読める | 更新頻度が低いページ(会社案内、ドキュメント) | 内容を更新するたびに再生成が要る |
| ハイドレーション(SSRや静的生成+ブラウザで動きを付ける) | サーバーの初回応答。その後ブラウザでJavaScriptが操作を担う | 初期HTMLで本文を読める | 本文は検索に出し、画面上の操作も多いサービス | 初期HTMLとJavaScript実行後の内容を一致させる |
| 動的レンダリング | ユーザーにはCSR、クローラーにはサーバーで生成したHTMLを返す | クローラー向けのHTMLを読む | 既存のCSRサイトで、作り直すまでのつなぎ | Googleは「回避策」とし、推奨していない。管理する出力が2つになる |
選ぶときは、そのページに検索から来てほしいかを最初に見ます。ログイン後の画面のように、Googlebotが見ることのないページはCSRのままで差し支えありません。検索から来てほしいページは、初期HTMLに本文が入る方式が候補で、ページ数と更新の頻度で分かれます。ページ数が少なく更新もまれなら静的生成で足ります。商品や在庫のように内容が頻繁に変わるページや、ページ数が多くて生成し直す手間が大きいサイトはSSRが向きます。画面上の操作も多いサービスならハイドレーションです。ページの種類ごとに方式を変えることもできます。
動的レンダリングについては、Googleの位置づけが変わっています。「ダイナミック レンダリングは回避策であり、JavaScript 生成コンテンツに関して検索エンジンで生じる問題の根本的な解決策ではありません。」と明記され、仕組みが複雑になり多くのリソースが必要になるため推奨しない、とも書かれています。代わりに挙げられているのは、サーバーサイドレンダリング・静的なレンダリング・ハイドレーションです。古い解説記事には動的レンダリングを推奨するものが多いので、日付を見てください。
クローキングとは、ユーザーとクローラーに違う内容を見せる行為です。動的レンダリングとクローキングの関係も、Googleが説明しています。ユーザーとクローラーに同様の内容を返していれば問題にはならず、まったく違う内容を返す場合はクローキングと判断される、という整理です。
ReactやVueを単体で使うと、既定ではCSRになります。ReactならNext.js、VueならNuxtのようなフレームワークは、ページごとにSSRや静的生成を選べます。同じReactで作ったサイトでも、出力の方式をどう設定したかで初期HTMLの中身は変わります。各フレームワークでの実装手順は、この記事では扱いません。
Googleも「サーバー側でのレンダリング(プリ レンダリング)も有効な方法として検討してみてください」と書いています。SSRや静的生成は表示速度にも関わりますが、Core Web Vitalsとの関係は「Core Web Vitals」の記事に任せます。
出典:回避策としてのダイナミック レンダリング/JavaScript SEO の基本を理解する
Search ConsoleのURL検査で自分のサイトを確かめる手順
使うのはSearch ConsoleのURL検査ツールで、ヘルプには公開URLのテストで「レンダリングされたページのスクリーンショット、返された未加工の HTML、HTML ヘッダー、JavaScript コンソールの出力、読み込まれたすべてのページリソース」が確認できると書かれています。
- 公開URLをテストする:Search ConsoleのURL検査に、確かめたいページのURLを入れます。結果画面の「公開URLをテスト」を押すと、Googleがそのページをその場で取得してレンダリングします。
- レンダリング後のHTMLで本文とリンクを探す:「テスト済みのページを表示」→「HTML」タブを開きます。ここに出るのがレンダリング後のHTMLです。本文からコピーした文章と、/products/1234/ のような主要なリンクのURLを文字列検索します。見つからなければ、その部分はレンダリングの段階で出ていない可能性が高いので、次の手順で原因を調べます。
- 読み込めなかったファイルとエラーを見る:「その他の情報」→「ページのリソース」で、取得できなかったJavaScriptやCSSがないかを見ます。「JavaScript コンソール メッセージ」にエラーがあれば、そこで処理が止まり、以降の本文が追加されていない可能性があります。
- スクリーンショットは参考程度にする:スクリーンショットは「公開テストで成功した場合のみ」表示されます。折りたたみや遅延読み込みの部分は写らないため、判断はHTMLタブで行ってください。
- 所有していないサイトはリッチリザルトテストで見る:制作会社のデモ環境のように、Search Consoleに登録していないサイトは、リッチリザルトテストで同じようにレンダリング後のHTMLを確認できます。
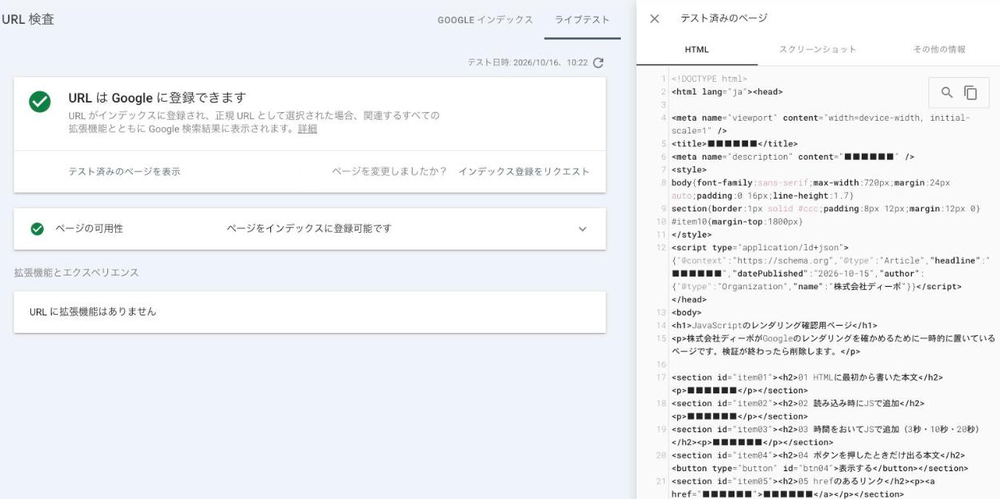
上の画像は、当社の検証で「テスト済みのページを表示」のHTMLタブを開いた画面です。テストページのURLと確認用の文字列は■で隠しています。
制限もあります。「ログイン時に必要な情報なしでインターネットからページにアクセスできる必要があります」とあり、会員限定のページは試せません。
読まれていない箇所が見つかったときに、開発側へ伝える文例です。
- レンダリング後のHTMLに、一覧ページから詳細ページへのリンクが入っていません。aタグにhref属性でURLを入れてください
- 一覧の2ページ目以降がレンダリング後のHTMLに含まれません。?page=2 のような固有のURLを用意し、前後のページへのリンクをhrefで置いてください
- ページのリソースで /assets/app.js が取得できていません。robots.txtで拒否していないか確認してください
出典:URL 検査ツール/Google 検索における JavaScript の問題を解決する
title・meta description・構造化データをJavaScriptで出すとき
Googleタグマネージャーで入れたJSON-LDは読まれるのか。ページごとにtitleをJavaScriptで書き換えている作りは大丈夫なのか。
Googleは可としています。「<title> 要素とメタ ディスクリプションは、JavaScript で設定または変更できます。」「JavaScript を使用して必要な JSON-LD を生成し、ページに挿入できます。」と書かれています。当社検証のNo.8・No.12のとおり、書き換え後のtitleと挿入したJSON-LDは残りました。
ただし、レンダリングを待っている間、Googleが持っているのは初期HTMLの値です。初期HTMLのtitleが「読み込み中」や全ページ共通のサイト名だと、レンダリングが済むまではその値で扱われ得ます。初期HTMLとJavaScript実行後で値が食い違うと、管理もしづらくなります。可能なら、titleとmeta descriptionは初期HTMLに正しい値を入れ、JavaScriptでの書き換えは補助にとどめる方が安全です。
JSON-LDの書き方と、タグマネージャーで挿入するときの注意は「JSON-LDとは?構造化データの書き方と実装手順・テスト方法」で解説しています。
JavaScript SEOのよくある質問
#section-1 のようなページ内の目次リンクも、フラグメントとして問題になりますか
なりません。Googleが避けるよう書いているのは、フラグメントで別のページの内容を読み込む設計です。同じページの中の見出しへ移動する目次リンクは、本来の使い方で問題ありません。
JavaScriptのファイルを更新したのに、Googleが古い内容で表示します
Googleのレンダリングの仕組みはWRSと呼ばれ、「WRS はキャッシュ ヘッダーを無視することがあります」と書かれています。このため、古いJavaScriptを使い続けることがあります。対処として、Googleは「ファイル名の一部をコンテンツのフィンガープリントにする(main.2bb85551.js など)」方法を挙げています。内容が変わるとファイル名も変わるため、別のファイルとして取得されます。
Web ComponentsやShadow DOMの中身は読まれますか
読まれます。「Google がページをレンダリングする際、Shadow DOM と Light DOM のコンテンツがフラット化されます。」と書かれています。注意が要るのは、部品の外から差し込んだ内容をslot要素で受けていない場合です。この内容はLight DOMと呼ばれ、slot要素で受けていないと、レンダリング後のHTMLに出ません。
スクロールに合わせて現れるアニメーションやスライダーは、SEOに不利ですか
本文とリンクが初期HTMLに入っていて、動きは見せ方を変えているだけなら、不利にはなりません。不利になるのは、動きに合わせて本文を後から足す作りです。当社の検証では、最初から書いた本文や、開いた直後に追加した本文、要素が画面に入ったときに追加した本文は残りました。スクロール量やボタンのクリックを条件にした本文は、Googleがスクロールもクリックもしないため残っていません。10秒後・20秒後に追加した本文も残りませんでした。どの作りが残ったかは、当社の検証の結果で確かめられます。
スライダーやタブも同じで、全スライドの本文とhref付きのリンクを初期HTMLに入れ、表示だけを切り替える作りなら読まれます。動きより注意したいのは、見出しやキャッチコピーを画像にしたり、文字を図形に変換したSVGにしたりする作りです。見た目を優先したページで多く、文字として読めません。画像にするなら、少なくともalt属性に同じ文言を入れてください。
上の条件を守れば、検索からの集客を狙うページでも動きは使えます。確かめるときは、URL検査のHTMLタブで、本文からコピーした文章を検索します。
Googleがレンダリングを待つ時間は何秒ですか
公式ドキュメントに具体的な秒数の記述はありません。当社の検証で何秒後の追加まで残ったかは検証の結果のとおりで、Googleの仕様とは受け取らないでください。主要な本文は初期HTMLか読み込み直後に出す作りにしておけば、時間に頼らずに済みます。
まとめ:まずメインページをURL検査で見る
次の手順で、御社のサイトのメインページを確かめてください。
- 一覧ページと詳細ページを1本ずつ選び、Search ConsoleのURL検査で「公開URLをテスト」を実行する
- 「テスト済みのページを表示」のHTMLタブで、本文からコピーした文章と主要なリンクのhrefを文字列検索する
- 「ページのリソース」と「JavaScript コンソール メッセージ」でエラーを見る
- 読まれていない箇所があれば、上で示した直し方の該当項目を開発側に伝える
テクニカルSEO全体の整理は「SEO内部対策とは?施策やチェックリスト25項目など徹底紹介!」をご覧ください。
この記事の監修者
金田一 健次 きんだいち けんじ
株式会社ディーボ 執行役員。2006年入社、SEO・リスティング広告の運用を中心にウェブマーケティングに従事。無料SEOツール群(hanasakigani、aramakijake等)やBULL、キーワードファインダーの開発を主導し、現在はSEO・GEO対策の普及と技術的アプローチの探求に努める。
記事を増やしても検索順位が上がらない…なぜ?
記事を増やしても検索順位が上がらない…なぜ?
順位が上がらない原因は、新しく足すものではなく、これまで作ってきたページの中にあることがあります。
例えば、同じ内容のページが複数のURLで存在している、サイト内のページ同士が同じキーワードを奪い合っている、Googleに認識されていないページがある、といった状態です。
こうした問題は、サイトを運用している側ほど気づきにくいものです。
ご依頼のURLをもとにサイト全体を調べ、見直すべき箇所と直す順番を無料でお伝えします。
- « 前の記事
JSON-LDとは?構造化データの書き方と実装手順・テスト方法 - 次の記事 »
検索順位を上げたり、検索流入を増やすにはSEOが重要!